هیچ محصولی در سبد خرید نیست.
7دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
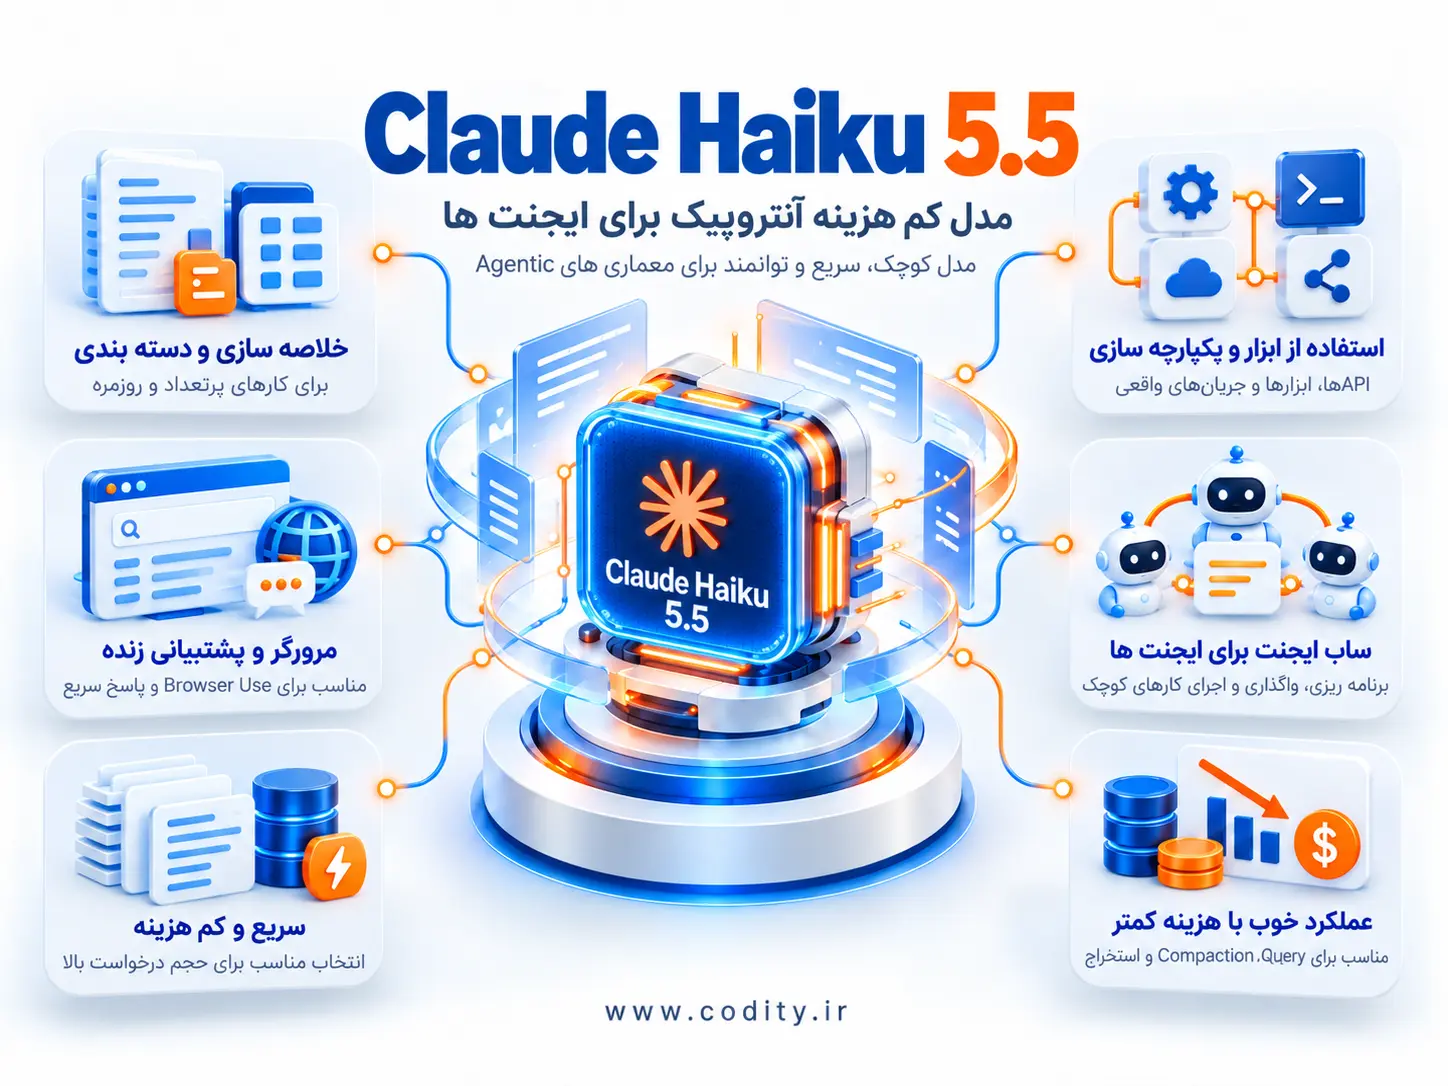
Claude Haiku 5.5 مدل کوچک و سریع جدید آنتروپیک است که برای کارهای پرتعداد، حساس به هزینه و سناریوهای Agentic طراحی شده است. آنتروپیک این مدل را در 7 اکتبر 2026 معرفی کرد و آن را سریع ترین، ارزان ترین و توانمندترین مدل کوچک خود تا امروز می داند. تمرکز نسل تازه روی خلاصه سازی، دسته بندی، Queryهای پایگاه داده، Compaction، پشتیبانی زنده، Browser Use و نقش Subagent در کنار مدل های بزرگ تر است. نکته مهم این است که نتایج بنچمارک ها جهش بزرگی نسبت به Haiku 4.5 نشان می دهند و در چند ارزیابی، مدل حتی از GPT-6 Luna جلوتر قرار گرفته است.
آنتروپیک این مدل را برای High-volume و Cost-sensitive Work معرفی می کند. یعنی وظایفی که ممکن است هزاران بار اجرا شوند و استفاده از یک مدل بزرگ برای همه آن ها از نظر هزینه منطقی نباشد. خلاصه کردن اسناد، طبقه بندی درخواست ها، مسیریابی پیام ها، استخراج اطلاعات، Queryهای مشخص و پاسخ های کوتاه از کاربردهای اصلی هستند.
مدل می تواند در معماری Agentها به عنوان Subagent کنار Opus 5.5 یا Sonnet 5.5 کار کند. مثلا مدل بزرگ تر برنامه کلی پروژه را مدیریت کند و Haiku وظایف کوچک تر مثل خواندن یک فایل، پیدا کردن یک عدد در گزارش یا خلاصه کردن نتیجه را انجام دهد. این تقسیم کار می تواند هزینه و زمان کل Workflow را کاهش دهد.
طبق جدول مقایسه ای که برای این نسل منتشر شده، در Knowledge Work با معیار GDPval-AA v2.1 امتیاز مدل جدید 1620 است، در حالی که Haiku 4.5 امتیاز 735 دارد. در AA-Briefcase v1.1 نیز نتیجه 1578 در برابر 614 است.
اختلاف در Computer Use حتی بیشتر دیده می شود. در OSWorld 2.1 روی زیرمجموعه آفلاین، مدل جدید به 72.4 درصد رسیده و نسل قبلی 15.7 درصد گرفته است. در Visual Reasoning با Chartography نیز امتیاز از 6.4 درصد به 46.4 درصد افزایش پیدا کرده است.
در Agentic Coding نیز Terminal-Bench 4.0 نتیجه 39.2 درصد را برای نسل تازه نشان می دهد، در حالی که Haiku 4.5 در همان جدول صفر درصد ثبت کرده است. این اعداد نشان می دهند تغییر فقط مربوط به سرعت یا قیمت نیست و توانایی انجام کار واقعی نیز رشد زیادی داشته است.
جدول منتشر شده مقایسه مستقیمی با GPT-6 Luna هم دارد. در GDPval-AA، Haiku امتیاز 1620 و Luna امتیاز 1437 گرفته است. در AA-Briefcase نیز نتیجه 1578 در برابر 1336 است.
در OSWorld 2.1، Haiku با 72.4 درصد بالاتر از 48.9 درصد Luna قرار می گیرد. در Chartography هم نتیجه 46.4 درصد در برابر 29.1 درصد است. در Terminal-Bench 4.0 امتیازها 39.2 و 16.4 درصد هستند.
در FrontierCode 1.1 فاصله کمتر می شود؛ Haiku امتیاز 46.4 درصد و Luna امتیاز 42.4 درصد دارد. بنابراین در همه ردیف های جدول که برای هر دو مدل عدد منتشر شده، مدل کوچک آنتروپیک امتیاز بالاتری دارد، هرچند فاصله در هر آزمون متفاوت است.
Sonnet 5.5 همچنان مدل قوی تری برای کارهای پیچیده است. در GDPval-AA امتیاز Sonnet برابر با 1840 و Haiku برابر با 1620 است. در AA-Briefcase نیز Sonnet به 1824 و Haiku به 1578 رسیده است.
در Computer Use امتیازها 83.9 درصد برای Sonnet و 72.4 درصد برای Haiku هستند. در Terminal-Bench 4.0 اختلاف بیشتر می شود: 70.6 درصد در برابر 39.2 درصد. در FrontierCode 1.1 نیز Sonnet با تنظیم xhigh امتیاز 52.1 درصد و Haiku امتیاز 46.4 درصد گرفته است. در Chartography هم نتیجه 61.6 درصد در برابر 46.4 درصد است.
پس هدف Haiku جایگزینی کامل Sonnet نیست. این مدل برای وظایفی طراحی شده که سرعت، حجم بالا و هزینه اهمیت بیشتری دارند. آنتروپیک نیز Sonnet 5.5 را گزینه قوی تر برای کارهای حرفه ای با محدوده مشخص معرفی می کند.
در Humanity’s Last Exam بدون ابزار، Haiku جدید امتیاز 45.9 درصد دارد، Haiku 4.5 امتیاز 10.2 درصد و Sonnet 5.5 امتیاز 56.9 درصد گرفته است.
وقتی ابزارها در اختیار مدل قرار می گیرند، امتیاز Haiku به 57.4 درصد افزایش پیدا می کند. نسل قبلی در این حالت 18.7 درصد و Sonnet 5.5 امتیاز 64.5 درصد دارد. این نتیجه برای Agentها مهم است، چون آن ها معمولا به جستجو، فایل، دیتابیس یا Browser دسترسی دارند و توانایی استفاده درست از Tool می تواند کیفیت نهایی را بالا ببرد.
یکی از تغییرهای مهم این نسل، اضافه شدن تنظیم Effort است. آنتروپیک می گوید این اولین مدل کلاس Haiku است که Adjustable Effort دارد. توسعه دهنده می تواند میزان تلاش مدل را بر اساس نیاز تنظیم کند و میان هزینه، سرعت و کیفیت تعادل بسازد.
برای درخواست های ساده می توان Effort پایین تری انتخاب کرد و برای Taskهای دشوارتر منابع بیشتری در اختیار مدل گذاشت. این ویژگی در سرویس هایی با حجم درخواست بالا کمک می کند همه کارها با سطح یکسانی از پردازش اجرا نشوند.
برای Promptهای تا 100 هزار Token، هزینه هر یک میلیون Token ورودی 0.10 دلار و خروجی 0.50 دلار است. اگر Prompt از 100 هزار Token عبور کند، قیمت ورودی به 0.50 دلار و خروجی به 2.50 دلار می رسد. آنتروپیک همچنین اعلام کرده Prompt Caching می تواند تا 90 درصد و Batch Processing تا 50 درصد هزینه را کاهش دهد.
طبق اعلام رسمی، اجرای مدل جدید به طور میانگین حدود 75 درصد ارزان تر از Haiku 4.5 تمام می شود. این تفاوت برای Agentهایی که در یک وظیفه چندین بار مدل را فراخوانی می کنند اهمیت زیادی دارد.
در یک Agent پیچیده ممکن است مدل اصلی وظیفه را برنامه ریزی کند و چند Subagent بخش های کوچک را انجام دهند. اگر همه این مراحل با مدل بزرگ اجرا شوند، هزینه خیلی سریع افزایش پیدا می کند.
Haiku می تواند کارهایی مثل خلاصه سازی، استخراج، Routing، بررسی اسناد و Queryهای کوچک را با هزینه پایین انجام دهد. Cognition نیز در Devin Fusion از آن به عنوان Sidekick کنار Opus 5.5 استفاده کرده و گزارش داده است که این ترکیب هزینه و Latency را کاهش می دهد.
آنتروپیک این مدل را سریع ترین مدل خود هم معرفی می کند. همین ویژگی برای Live Customer Support، Voice Agent، Browser Use و تجربه های Real-time اهمیت زیادی دارد.
HubSpot گزارش کرده مدل جدید در مجموعه تست CRM داخلی آن ها میان مدل های کوچک بهترین نتیجه را داشته و میانگین 92.8 درصد را در سه اجرا ثبت کرده است. در یک Task مربوط به تشخیص رکوردهای قدیمی و مبهم نیز سریع ترین مدل بوده و بیشترین Hit Rate و کمترین False Positive را داشته است.
AlphaSense مدل را روی 400 Query آزمایش کرده و امتیاز 0.84 را در برابر 0.76 برای Haiku 4.5 گزارش کرده است. Box نیز گفته نسل جدید در آزمایش های اولیه 11 امتیاز بالاتر از مدل قبلی گرفته و تقریبا نصف Latency را داشته است. این نتایج توسط شرکت های همکار گزارش شده اند و تضمین نمی کنند همه پروژه ها دقیقا همین اختلاف را ببینند.
کاربران Free، Pro، Max، Team و Enterprise می توانند Haiku جدید را در Claude.ai روی وب، iOS و Android انتخاب کنند. توسعه دهندگان نیز از طریق Claude Platform به آن دسترسی دارند و شناسه API مدل claude-haiku-5-5 است.
مدل در Amazon Web Services، Google Cloud و Microsoft Foundry نیز ارائه شده و داخل Claude Code قابل استفاده است. این گستردگی دسترسی نشان می دهد آنتروپیک آن را برای استفاده واقعی در محصولات و Agentها عرضه کرده است.
برای خلاصه سازی، Classification، Routing، Compaction، Queryهای مشخص، Subagentها و سرویس های Real-time، مدل کوچک جدید انتخاب منطقی تری است. در این کارها هزینه و Latency معمولا به اندازه کیفیت اهمیت دارند.
برای Complex Coding و Knowledge Work سنگین، آنتروپیک Opus 5.5 را گزینه اصلی تر می داند. Sonnet 5.5 نیز برای کارهای حرفه ای با محدوده مشخص، رفع Bug و تولید خروجی های کامل جایگاه میانی دارد. انتخاب درست باید با اندازه گیری Cost per Task و کیفیت واقعی روی داده پروژه انجام شود.
Claude Haiku 5.5 نشان می دهد مدل کوچک دیگر لزوما به معنی مدل ضعیف نیست. طبق جدول مقایسه، نسل تازه نسبت به Haiku 4.5 جهش بزرگی در Knowledge Work، Computer Use، Agentic Coding، استدلال چندرشته ای و Visual Reasoning دارد و در معیارهای مشترک منتشر شده از GPT-6 Luna نیز جلوتر قرار گرفته است.
Sonnet 5.5 همچنان در بیشتر آزمون های سنگین امتیاز بالاتری دارد، اما مزیت Haiku ترکیب سرعت، قیمت و توانایی است. Adjustable Effort، قیمت بسیار پایین API و مناسب بودن برای Subagentها باعث می شوند این مدل برای معماری هایی که باید تعداد زیادی Task را اجرا کنند گزینه مهمی باشد.

در مقایسه ChatGPT و Claude برای تحلیل فایلهای طولانی و پروژههای کاری، اگر به جمعبندی دقیق با استناد به بخشهای متن نیاز دارید...
اگر برای کدنویسی، کار با کامپیوتر یا پروژه های حرفه ای به مدلی قدرتمند نیاز داری اما نمی خواهی هزینه GPT-6 Astra را...
Eleven v4 نسل جدید مدل Text to Speech شرکت ElevenLabs است که برای تولید صدای طبیعی تر، احساسی تر و پایدارتر ساخته شده...
ChatGPT Dots ایجنت شخصی و همیشه فعال OpenAI در ChatGPT است که می تواند یک مسئولیت را بگیرد و بین گفتگوها به کار...
Gemini 4 Argon مدل Frontier جدید گوگل و اولین عضو معرفی شده از نسل Gemini 4 است که برای انجام کارهای پیچیده، طولانی...