هیچ محصولی در سبد خرید نیست.
8دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
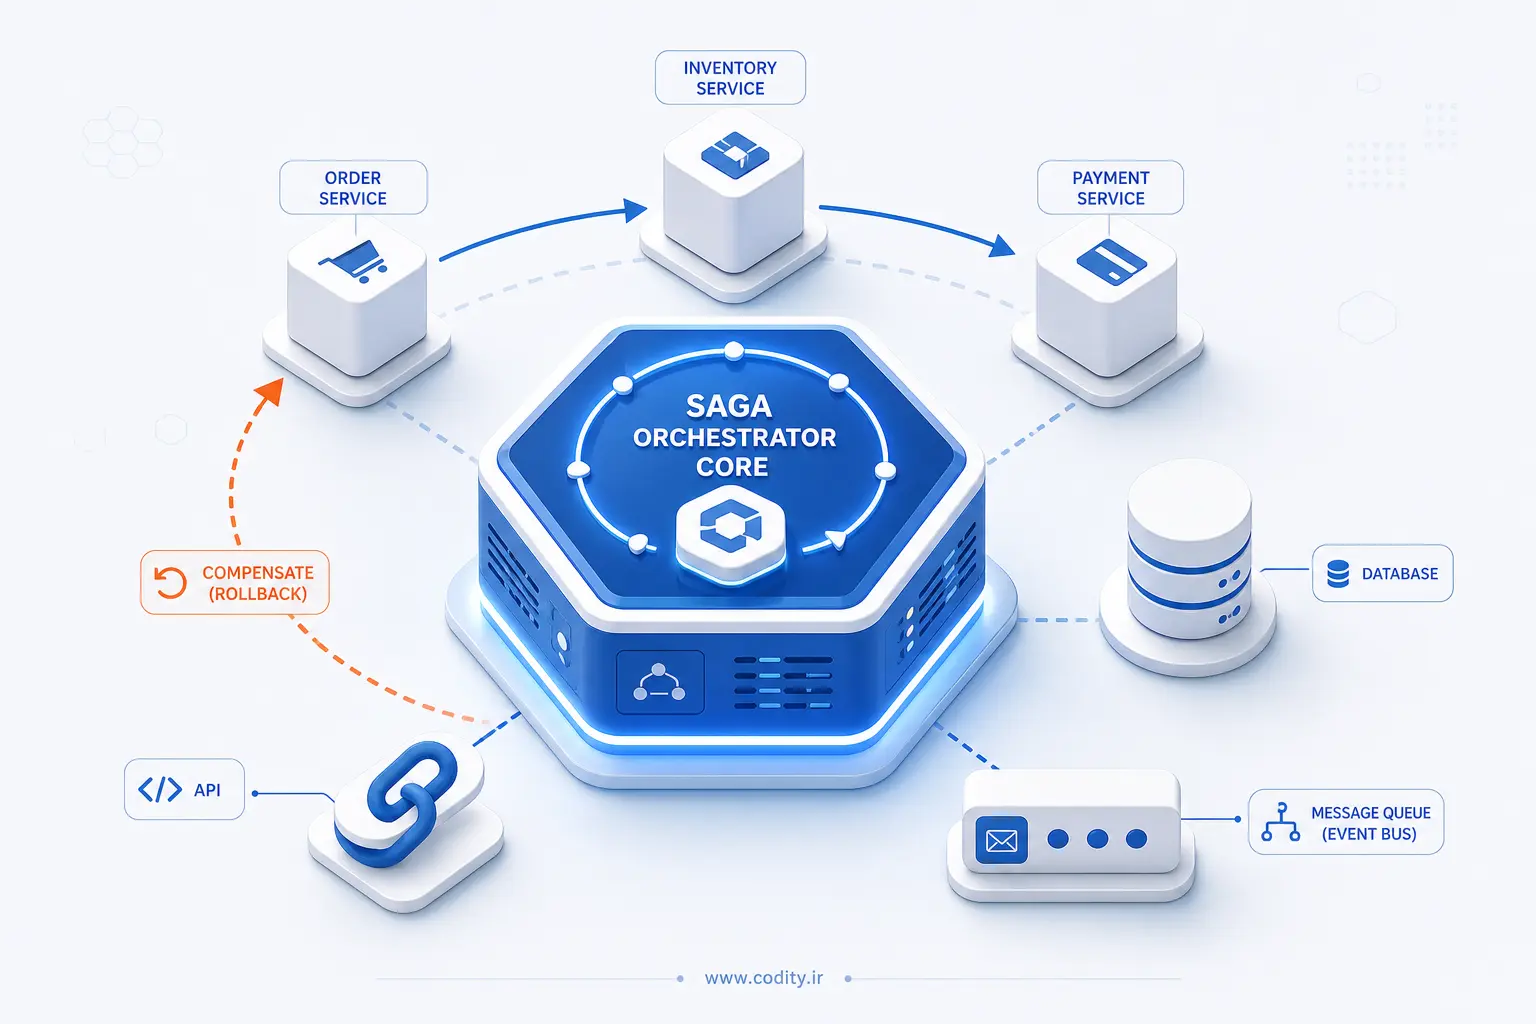
Saga Pattern در میکروسرویس روشی است برای مدیریت تراکنش های توزیع شده: به جای یک تراکنش سراسری بین سرویس ها، زنجیره ای از تراکنش های محلی با عملیات جبرانی تعریف می شود تا در صورت خطا اثرها برگردانده شوند و داده ها به سازگاری نهایی برسند. هماهنگی این زنجیره یا با ارکستراسیون توسط یک هماهنگ کننده مرکزی انجام می شود یا با کُرئوگرافی مبتنی بر رویداد بین خود سرویس ها.
سگا دنباله ای از چند تراکنش محلی مستقل است که هر کدام در پایگاه داده همان سرویس به صورت اتمیک اجرا می شوند. اگر هر قدم شکست بخورد، برای همه قدم های موفق قبلی عملیات جبرانی (Compensating Action) اجرا می شود؛ مثلا لغو رزرو موجودی یا بازگشت وجه. بنابراین به جای قفل طولانی داده ها و 2PC، با پذیرش سازگاری نهایی (Eventual Consistency) و تعریف جبران، کسب و کار پایدار می ماند.
دو سبک رایج هماهنگی عبارتند از:
از Saga استفاده کنید اگر:
بهتر است استفاده نکنید اگر:
هماهنگ کننده مسیر را کنترل می کند. مزایا: ساده تر برای استدلال، رصد و نسخه بندی فرآیند. معایب: وابستگی مرکزی و نیاز به مقیاس پذیری هماهنگ کننده.
هر سرویس با دریافت یک رویداد، کار خودش را انجام می دهد و نتیجه را به صورت رویداد جدید منتشر می کند. مزایا: کوپلینگ کمتر و تکامل پذیری بالا. معایب: مشاهده پذیری دشوارتر و احتمال حلقه یا انفجار رویداد اگر قراردادها شفاف نباشند.
سرویس ها: Order، Inventory، Payment، Shipping.
نمونه زیر ایده ارکستراسیون Saga را با فراخوانی سرویس ها و جبران نمایش می دهد. این کد برای فهم الگو است و جایگزین زیرساخت پیام رسان، ذخیره وضعیت Saga و کنترل خطا در محیط تولید نیست.
// pseudo-orchestrator.ts (آموزشی)
type OrderId = string;

interface Services {
  order: {
    createPending: (orderId: OrderId) => Promise<void>;
    confirm: (orderId: OrderId) => Promise<void>;
    cancel: (orderId: OrderId, reason: string) => Promise<void>;
  };
  inventory: {
    reserve: (orderId: OrderId) => Promise<void>;
    release: (orderId: OrderId) => Promise<void>;
  };
  payment: {
    capture: (orderId: OrderId) => Promise<void>;
    refund: (orderId: OrderId) => Promise<void>;
  };
  shipping: {
    schedule: (orderId: OrderId) => Promise<void>;
    cancelSchedule: (orderId: OrderId) => Promise<void>;
  };
}

export async function placeOrderSaga(orderId: OrderId, sv: Services) {
  let step = 0;
  try {
    await sv.order.createPending(orderId); // step 1
    step = 1;

    await sv.inventory.reserve(orderId);   // step 2
    step = 2;

    await sv.payment.capture(orderId);     // step 3
    step = 3;

    await sv.shipping.schedule(orderId);   // step 4
    step = 4;

    await sv.order.confirm(orderId);       // step 5
    step = 5;

  } catch (err: any) {
    // Compensation (برعکس قدم های موفق)
    if (step >= 4) {
      await safe(() => sv.shipping.cancelSchedule(orderId));
    }
    if (step >= 3) {
      await safe(() => sv.payment.refund(orderId));
    }
    if (step >= 2) {
      await safe(() => sv.inventory.release(orderId));
    }
    if (step >= 1) {
      await safe(() => sv.order.cancel(orderId, reasonFrom(err)));
    }
    throw err;
  }
}

async function safe(fn: () => Promise<unknown>) {
  try { await fn(); } catch { /* log and continue */ }
}

function reasonFrom(err: any): string {
  return (err && err.message) || "saga_failed";
}
در عمل باید وضعیت هر Saga را در یک استور مطمئن ذخیره کنید (State و Step)، با پیام رسان قابل اعتماد کار کنید، و جبران ها را ایمن و تکرار پذیر بنویسید.
رویدادهای اصلی:
{
  "OrderCreated": { "orderId": "o123", "items": [...], "total": 420000 },
  "InventoryReserved": { "orderId": "o123" },
  "InventoryFailed": { "orderId": "o123", "reason": "out_of_stock" },
  "PaymentCaptured": { "orderId": "o123" },
  "PaymentFailed": { "orderId": "o123", "reason": "card_declined" },
  "ShipmentScheduled": { "orderId": "o123", "tracking": "T-001" },
  "ShipmentFailed": { "orderId": "o123", "reason": "address_invalid" },
  "OrderConfirmed": { "orderId": "o123" },
  "OrderCancelled": { "orderId": "o123", "reason": "..." }
}
نمونه مصرف کننده با کنترل ایندمپوتنسی (پردازش تکراری بی خطر):
// inventory-consumer.js (آموزشی)
async function handleOrderCreated(evt, deps) {
  const id = evt.meta.id; // شناسه یکتا رویداد
  if (await deps.store.isProcessed(id)) return; // ایندمپوتنسی

  try {
    const ok = await deps.inventory.tryReserve(evt.orderId, evt.items);
    if (ok) {
      await deps.outbox.publish("InventoryReserved", { orderId: evt.orderId });
    } else {
      await deps.outbox.publish("InventoryFailed", { orderId: evt.orderId, reason: "out_of_stock" });
    }
    await deps.store.markProcessed(id);
  } catch (e) {
    // خطا را لاگ کنید و اجازه دهید سیستم با Retry پیام دوباره را تحویل دهد
    throw e; // at-least-once
  }
}
برای ارسال مطمئن رویدادها از Outbox Pattern استفاده کنید تا نوشتن در دیتابیس و درج رویداد در صف منطقا اتمیک باشد.
-- outbox table (آموزشی)
CREATE TABLE outbox (
  id BIGSERIAL PRIMARY KEY,
  aggregate_id TEXT NOT NULL,
  event_type TEXT NOT NULL,
  payload JSONB NOT NULL,
  status TEXT NOT NULL DEFAULT 'pending',
  created_at TIMESTAMP NOT NULL DEFAULT NOW()
);
یک پردازشگر Outbox رکوردهای pending را به بروکر پیام ارسال می کند و پس از موفقیت، وضعیت را به sent تغییر می دهد.
یک فرآیند محدود ولی واقعی مثل ثبت سفارش را انتخاب کنید، قدم ها و جبران ها را روشن بنویسید، سبک هماهنگی را بر اساس اولویت مانیتورینگ یا چابکی برگزینید، زیرساخت پیام رسان و Outbox را آماده کنید و سناریوهای شکست را قبل از انتشار به تولید به طور خودکار آزمایش کنید. با همین چرخه کوچک، الگوی پایدار خود را شکل می دهید و سپس آن را به سایر فرآیندها توسعه می دهید.

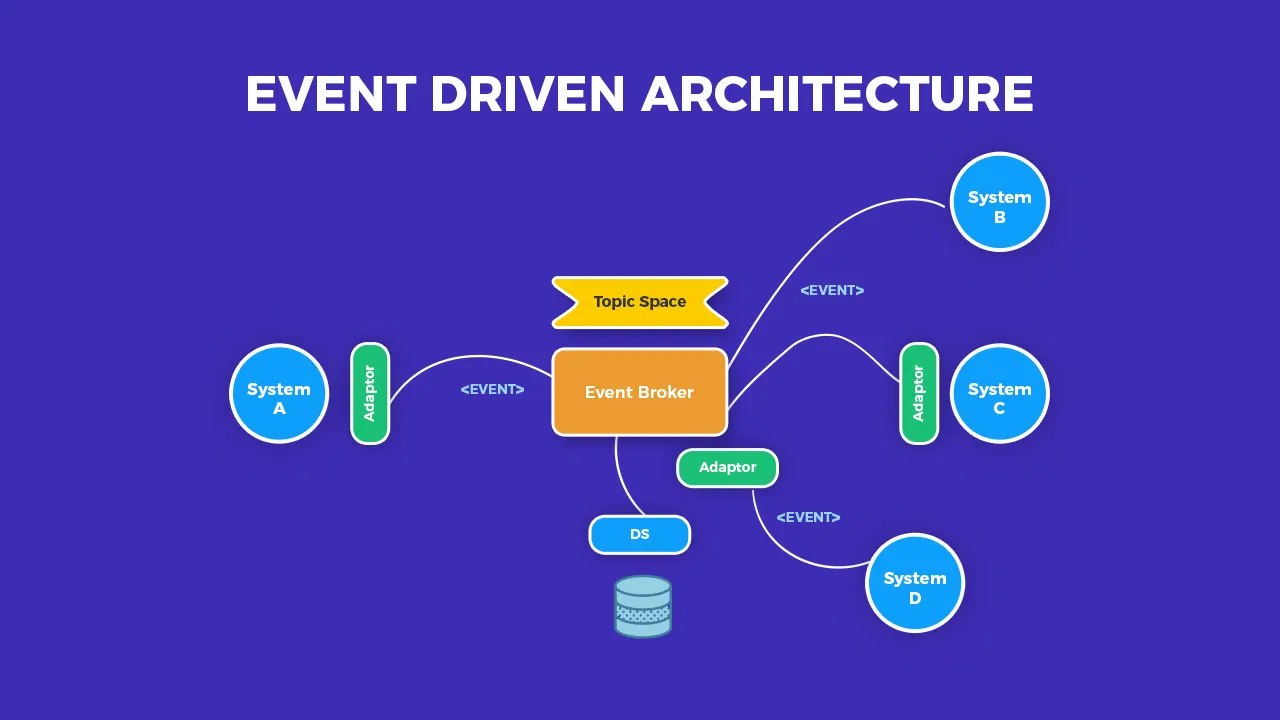
وقتی سیستم ها بزرگ می شوند، ارتباط مستقیم و همزمان بین اجزا خیلی زود به گلوگاه تبدیل می شود. اینجاست که سوال Event...
وقتی تعداد سرویس ها زیاد می شود و کلاینت ها مختلف می شوند، مدیریت ارتباط بین آنها به سرعت پیچیده می شود. اینجاست...

تقریبا هر کسی که مدتی در دنیای برنامه نویسی کار کرده، دیر یا زود با این سوال روبه رو می شود که System...

وقتی سیستم بزرگ می شود، فقط دانستن اینکه الان بالا است یا پایین، کافی نیست. باید بدانی کجا فشار وارد می شود، چه...

هر سیستم نرم افزاری تا وقتی همه چیز خوب پیش می رود، بی دردسر به نظر می رسد. اما مشکل دقیقا از جایی...