هیچ محصولی در سبد خرید نیست.
💻 ۱۳ سپتامبر، روز برنامه نویس مبارک؛ به همه کسانی که با کد، ایدهها را به واقعیت تبدیل میکنند. 🧡🩵
7دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
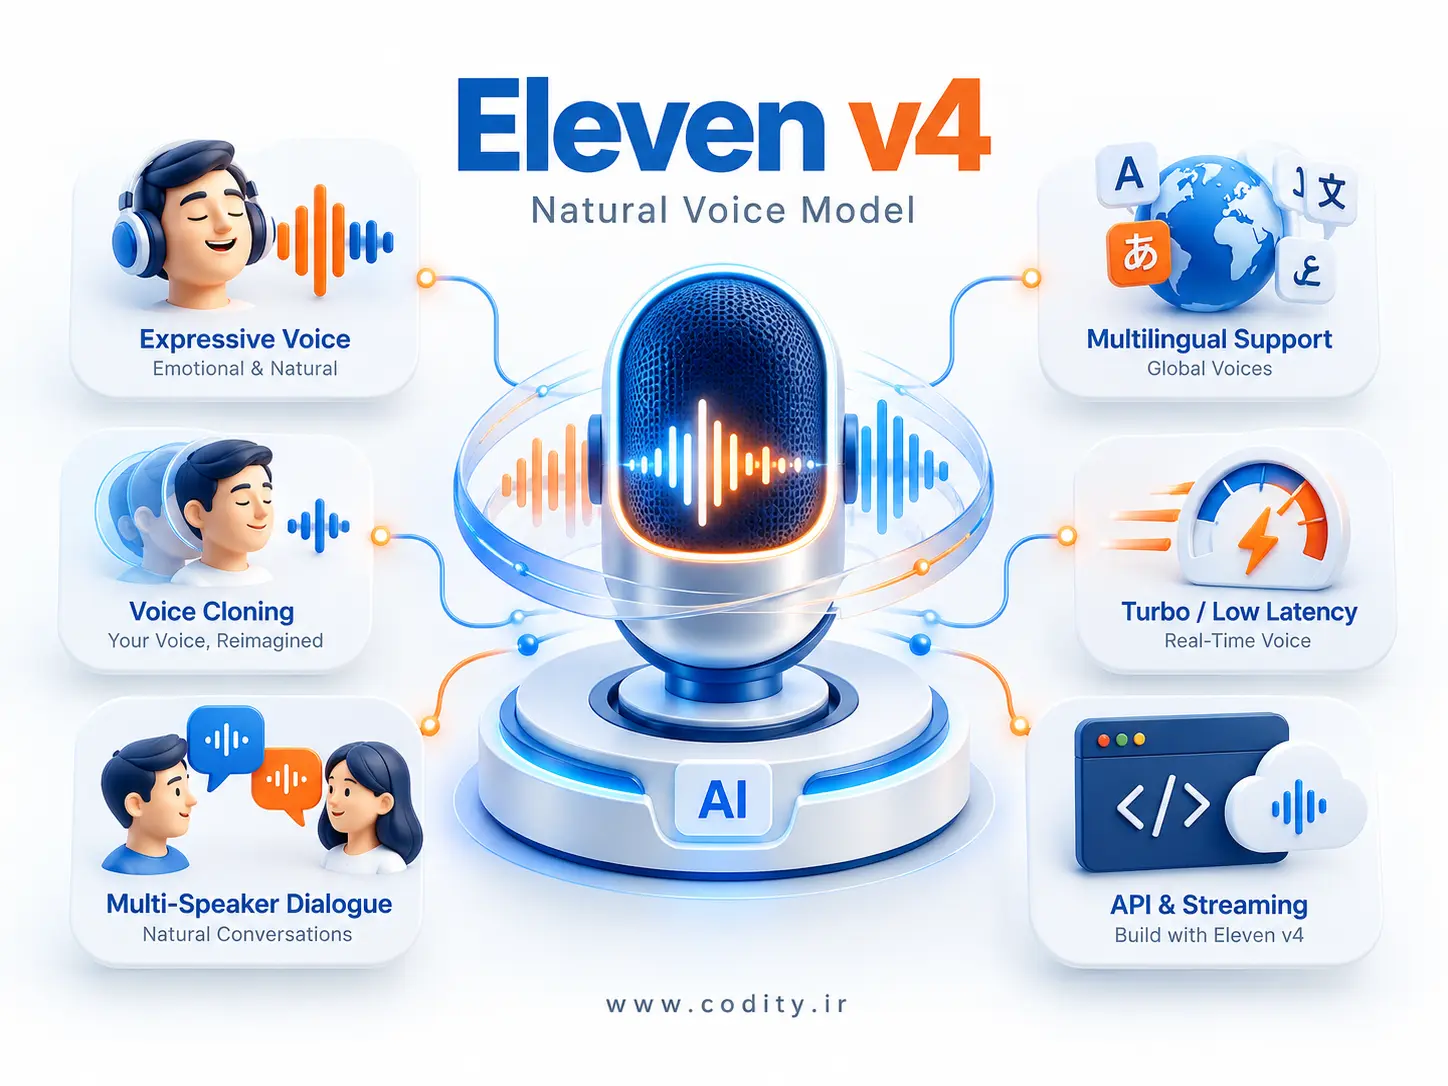
Eleven v4 نسل جدید مدل Text to Speech شرکت ElevenLabs است که برای تولید صدای طبیعی تر، احساسی تر و پایدارتر ساخته شده است. این مدل در 28 سپتامبر 2026 معرفی شد و همراه با نسخه سریع تر v4 Turbo در دسترس قرار گرفت. تمرکز نسل تازه فقط روی خواندن متن نیست؛ مدل تلاش می کند لحن، ریتم، احساس، شخصیت گوینده و Context جمله را درک کند و همان متن را متناسب با موقعیت اجرا کند. ElevenLabs همچنین از بهبود کیفیت صوت، Voice Cloning، گفتگوی چند گوینده و پشتیبانی زبانی گسترده تر خبر داده است.
مدل های Text to Speech سال هاست می توانند متن را با صدایی روان بخوانند، اما انتقال درست احساس هنوز یکی از دشوارترین بخش های تولید گفتار است. یک جمله ساده بسته به موقعیت می تواند آرام، مضطرب، جدی یا هیجان زده ادا شود. نسل جدید برای تشخیص همین تفاوت ها طراحی شده است.
ElevenLabs می گوید معماری مدل از نو ساخته شده و سیستم بهتر می تواند Tone، Pacing، Emotion، Character و Context را از متن دریافت کند. نتیجه قرار است بیشتر شبیه اجرای یک گوینده باشد تا خواندن مکانیکی جمله ها. این موضوع برای روایت داستان، دوبله، بازی، تبلیغات و محتوای صوتی اهمیت زیادی دارد.
این خانواده در دو نسخه ارائه شده است. نسخه اصلی روی بیشترین کیفیت و بیان احساسی تمرکز دارد و برای کتاب صوتی، Voice Over، دوبله و پروژه هایی مناسب است که کیفیت خروجی در اولویت قرار دارد.
نسخه Turbo برای کاربردهای Real-time ساخته شده است. ElevenLabs زمان میانه استنتاج آن را حدود 100 میلی ثانیه اعلام کرده و آن را برای Voice Agent و تجربه های تعاملی پیشنهاد می کند. در مقابل، برای رسیدن به این سرعت ممکن است کیفیت صوت کمی پایین تر از نسخه اصلی باشد.
طبیعی بودن صدا فقط به تلفظ صحیح واژه ها وابسته نیست. مکث، سرعت صحبت، شدت بیان و تغییر احساس در طول جمله هم نقش مهمی دارند. مدل جدید این نشانه ها را بهتر از متن استخراج می کند و می تواند اجرای آرام، فوری، طنز، احساسی یا نمایشی تولید کند.
ElevenLabs در آزمایش های Blind Preference خود اعلام کرده حدود 75 درصد شنوندگان خروجی مدل را در مقایسه مستقیم با چند مدل رقیب ترجیح داده اند. این نتیجه بر اساس تست های خود شرکت در سپتامبر 2026 است و بهتر است به عنوان ارزیابی منتشر شده توسط ElevenLabs دیده شود، نه معیار قطعی برای همه زبان ها و کاربردها.
یکی از قابلیت های مهم، Audio Tags است. کاربر می تواند داخل متن دستورهای کوتاهی قرار دهد تا مدل بفهمد بخشی از جمله چگونه اجرا شود. برای مثال تگ هایی برای Whisper، Shout، Laugh، Sigh و حالت های احساسی مختلف وجود دارند.
این روش شبیه دادن Direction به گوینده است. به جای اینکه فقط متن را وارد کنی، می توانی مشخص کنی یک جمله آرام گفته شود و جمله بعدی با هیجان بیشتری اجرا شود. مستندات ElevenLabs نمونه هایی مانند [whispers]، [laughs] و [sighs] را معرفی می کنند.
Voice Cloning یکی از بخش هایی است که ElevenLabs روی آن تاکید زیادی دارد. مدل جدید ویژگی های صدای مرجع مثل Timbre، Cadence و Delivery را دقیق تر حفظ می کند. در نتیجه صدای شبیه سازی شده در جمله ها و Generation های مختلف کمتر از هویت اصلی خود فاصله می گیرد.
Instant Voice Clone در این نسل دقیق تر شده است. Professional Voice Clone نیز به صورت کامل پشتیبانی می شود و برای پروژه هایی طراحی شده که ثبات و شباهت به صدای اصلی اهمیت زیادی دارد. البته برای استفاده حرفه ای باید رضایت صاحب صدا و شرایط استفاده از سرویس رعایت شود.
طبق مستندات فعلی ElevenLabs، مدل جدید از بیش از 90 زبان پشتیبانی می کند. نسل v3 بیش از 70 زبان را پوشش می داد، بنابراین دامنه زبانی در نسخه تازه گسترده تر شده است.
شرکت می گوید ریتم، احساس و Delivery در زبان های مختلف نیز بهتر شده است. اگر زبان متن با زبان صدای مرجع یکسان باشد، Accent اصلی حفظ می شود. اگر زبان مقصد متفاوت باشد، مدل تلاش می کند گفتار طبیعی زبان مقصد را تولید کند.
در پروژه هایی مثل Podcast، بازی یا داستان صوتی، چند شخصیت باید با هم تعامل کنند. اگر هر خط کاملا جدا تولید شود، مکالمه ممکن است مصنوعی به نظر برسد.
نسل تازه از Multi-speaker Dialogue پشتیبانی می کند و Context مکالمه را برای اجرای طبیعی تر گوینده ها در نظر می گیرد. مستندات رسمی برای نسخه اصلی محدودیت 10 هزار کاراکتر و پشتیبانی از گفتگوی چند گوینده را ذکر می کنند.
ساخت کتاب صوتی یا روایت طولانی معمولا نیاز دارد چند Generation پشت سر هم به هم متصل شوند. اگر Tone یا هویت صدا میان این بخش ها تغییر کند، شنونده خیلی زود متوجه ناهماهنگی می شود.
ElevenLabs می گوید Request Stitching در نسل جدید قابل اعتمادتر شده است. یعنی اتصال چند تولید برای محتوای طولانی بهتر انجام می شود و شخصیت، راوی یا صدای Clone شده ثبات بیشتری در طول پروژه دارد. این پیشرفت روی Studio و Reader App نیز اثر می گذارد.
Voice Agent باید با تاخیر بسیار کم پاسخ دهد. اگر سیستم چند ثانیه برای شروع صحبت زمان بخواهد، مکالمه طبیعی از بین می رود. برای همین نسخه Turbo اهمیت زیادی دارد.
ElevenLabs این نسخه را همراه ElevenAgents بهینه کرده است. Agent می تواند پاسخ تولید شده توسط مدل زبانی را سریع به گفتار تبدیل کند و همزمان لحن طبیعی تری داشته باشد. شرکت این ترکیب را برای پشتیبانی مشتری، دستیار تلفنی و تجربه های صوتی تعاملی در نظر گرفته است.
هر دو نسخه در ElevenCreative، ElevenAgents و ElevenAPI در دسترس هستند. برای نسخه اصلی شناسه eleven_v4 و برای نسخه Real-time شناسه eleven_v4_turbo استفاده می شود. توسعه دهندگان می توانند از REST API، Streaming و SDK های رسمی Python و JavaScript کمک بگیرند.
برای گفتار معمولی Create Speech و Stream Speech در دسترس هستند و برای چند گوینده می توان از Create Dialogue و Stream Dialogue استفاده کرد. در نتیجه همان فناوری را می توان داخل اپلیکیشن، بازی، سرویس تماس یا ابزار تولید محتوا قرار داد.
نسخه تازه همه کنترل های مدل های قبلی را عینا حفظ نکرده است. طبق مستندات فعلی، دو تنظیم اصلی Stability و Similarity در دسترس هستند، اما Style و Speed Slider برای این نسل ارائه نشده اند. SSML نیز پشتیبانی نمی شود.
طبیعی تر بودن مدل هم به معنی بی خطا بودن نیست. نام خاص، واژه تخصصی یا عبارت نادر ممکن است به اصلاح متن یا کنترل تلفظ نیاز داشته باشد. در پروژه حرفه ای بهتر است چند خروجی آزمایش شود و بخش های مهم قبل از انتشار گوش داده شوند.
اگر هدف ساخت کتاب صوتی، دوبله، Voice Over، شخصیت بازی، روایت داستان یا Podcast است، نسخه اصلی انتخاب مناسب تری است، چون کیفیت و بیان احساسی در اولویت قرار دارند. ElevenLabs نیز نسخه اصلی را برای Content Creation، Audiobooks و Character Voiceovers پیشنهاد می کند.
برای Voice Agent، تماس تعاملی و سیستم هایی که سرعت پاسخ حیاتی است، نسخه Turbo منطقی تر است. این تقسیم بندی اجازه می دهد توسعه دهنده بین کیفیت حداکثری و Latency پایین انتخاب کند.
نسل تازه ElevenLabs نشان می دهد مسیر Text to Speech از «خواندن طبیعی متن» به سمت «اجرای صوتی» در حال حرکت است. مدل لحن، احساس، ریتم و Context را بهتر تفسیر می کند، Voice Cloning دقیق تری دارد و گفتگوی چند گوینده را طبیعی تر اجرا می کند. پشتیبانی از بیش از 90 زبان و Request Stitching بهتر نیز آن را برای پروژه های طولانی و چندزبانه کاربردی تر کرده است.
در کنار نسخه اصلی، Turbo همین فناوری را با Latency حدود 100 میلی ثانیه به Agentها و کاربردهای Real-time می آورد. برای تولیدکننده محتوا مهم ترین مزیت کیفیت و کنترل احساسی است و برای توسعه دهنده، API و امکان انتخاب میان کیفیت و سرعت اهمیت بیشتری دارد.

ChatGPT Dots ایجنت شخصی و همیشه فعال OpenAI در ChatGPT است که می تواند یک مسئولیت را بگیرد و بین گفتگوها به کار...
Gemini 4 Argon مدل Frontier جدید گوگل و اولین عضو معرفی شده از نسل Gemini 4 است که برای انجام کارهای پیچیده، طولانی...
برای ساخت ایجنت هوش مصنوعی با n8n که پیامهای کاربران را به صورت خودکار جواب دهد، یک تریگر (مثلا تلگرام یا وبهوک) بسازید،...
اگر می خواهی یک ایجنت هوش مصنوعی بتواند به جای جستجوی دستی در دیوار، آگهی ها را پیدا کند، قیمت ها را مقایسه...
GPT-6 Sol and GPT-6 Luna دو مدل جدید خانواده GPT-6 هستند که OpenAI در 22 سپتامبر 2026 معرفی کرد. این دو مدل بخش...