هیچ محصولی در سبد خرید نیست.
9دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
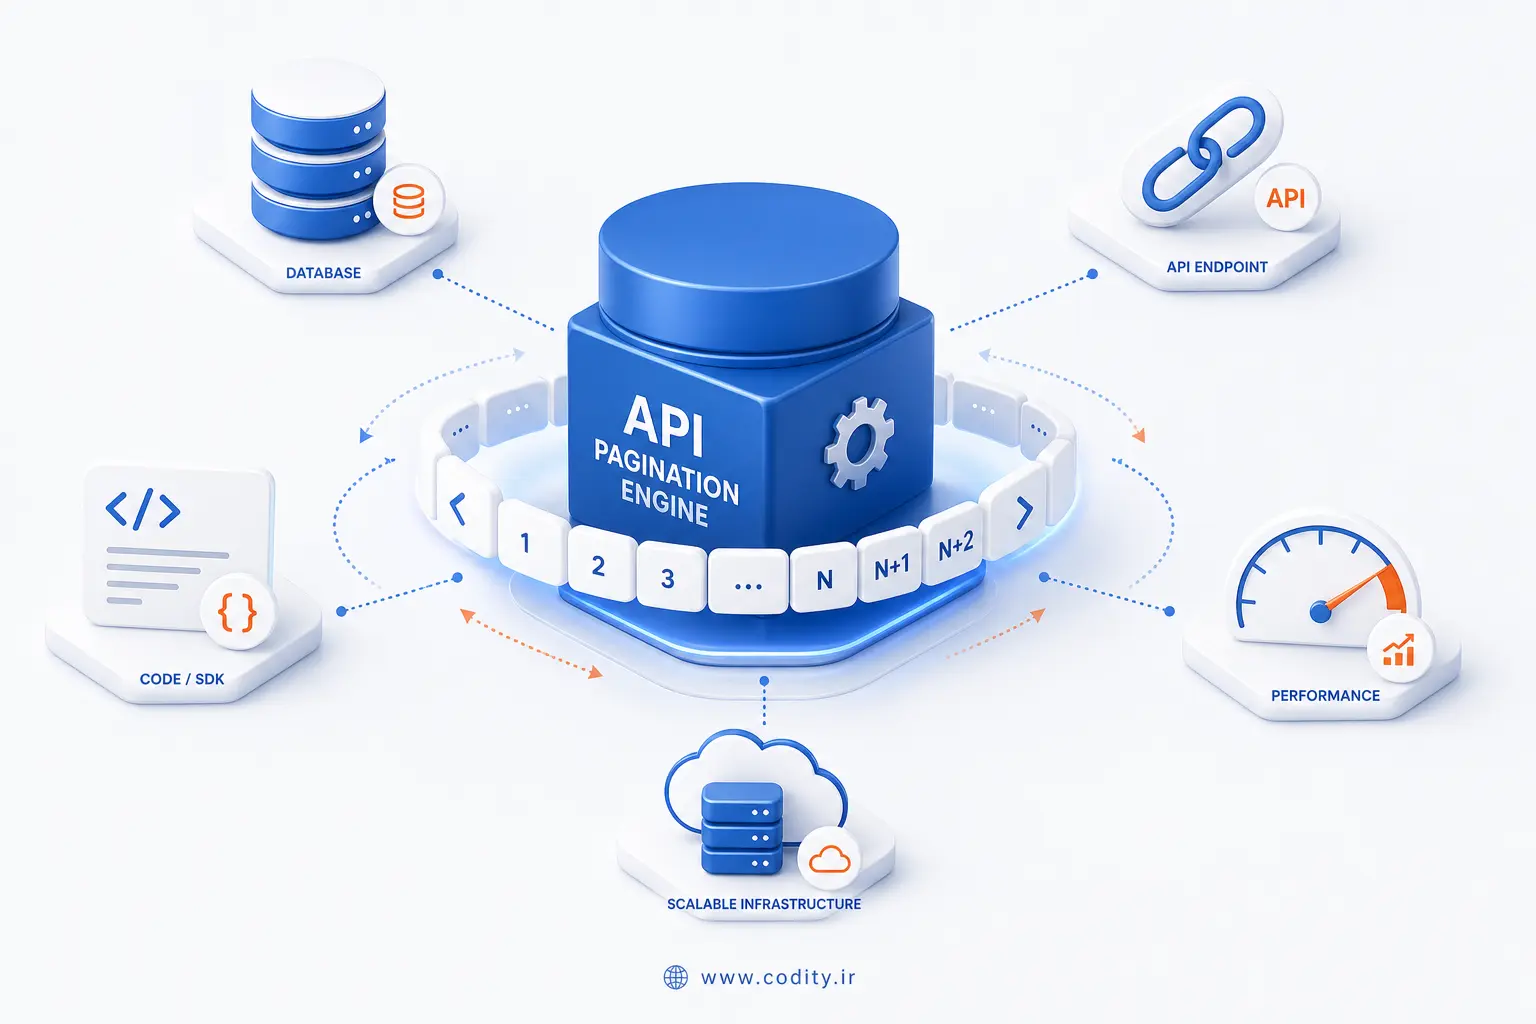
برای طراحی Pagination در API که روی داده های حجیم درست کار کند، از صفحه بندی مبتنی بر cursor با مرتب سازی پایدار و ایندکس مناسب استفاده کنید، اندازه صفحه را محدود و قابل تنظیم بگذارید (مثلا پیش فرض 50 و سقف 100)، پارامترها را واضح (limit و cursor یا page و per_page) تعریف کنید، در پاسخ متادیتا و لینک گام بعدی را برگردانید و از offset روی جداول خیلی بزرگ یا با نرخ درج بالا پرهیز کنید.
ساده و شهودی است: کاربر می گوید صفحه 10 با اندازه 20. برای داده های متوسط خوب است، اما روی مجموعه های بزرگ یا جدول هایی با درج/حذف مداوم، پرهزینه و ناپایدار می شود؛ هرچه page بزرگ تر، OFFSET بیشتری لازم است و پایگاه داده رکوردهای زیادی را دور می ریزد. در داده های در حال تغییر، امکان جابه جایی بین صفحات و تکراری/جاافتادگی وجود دارد.
به جای شماره صفحه، یک نشانه (cursor) برمی گردانید که موقعیت رکورد آخر صفحه فعلی را نشان می دهد. صفحه بعد براساس WHERE های «کم تر از/بالاتر از» آن موقعیت خوانده می شود. این روش روی جداول بزرگ، سریع و پایدار است، به شرطی که مرتب سازی قطعی و ایندکس مناسب داشته باشید. نقطه ضعف: پرش به صفحه دلخواه (مثلا صفحه 50) مستقیم نیست، اما معمولا برای UI های بی نهایت اسکرول یا «نمایش بیشتر» بهترین گزینه است.
وقتی داده ها بر اساس زمان مصرف می شوند (لاگ، رویداد)، می توانید از محدوده های زمانی صفحه بندی کنید. این روش ساده و همسو با ایندکس زمانی است، اما برای مرور تصادفی مناسب نیست.
این قراردادی است که هم ساده است و هم پاسخگو به نیازهای واقعی:
{
  "data": [
    { "id": 101, "title": "..." , "created_at": "2026-01-01T10:00:00Z" }
  ],
  "page": {
    "limit": 50,
    "nextCursor": "YmFzZTY0LWNvZGUtdHlwZS1lZzoxMDE6MjAyNi0wMS0wMVQxMDowMDowMFo=",
    "hasNext": true
  }
}
توجه: totalCount محاسبه گرانی است. اگر واقعا لازم است، آن را جداگانه و کش شده ارائه کنید.
در این مثال یک اندپوینت /articles با مرتب سازی created_at DESC, id DESC پیاده سازی می کنیم. برای محیط های تولید ایندکس ترکیبی زیر ضروری است:
CREATE INDEX CONCURRENTLY IF NOT EXISTS idx_articles_created_id
ON articles (created_at DESC, id DESC);import express from "express";
import { Pool } from "pg";
const app = express();
const pool = new Pool({ connectionString: process.env.DATABASE_URL });
app.get("/articles", async (req, res) => {
const perPageDefault = 20;
const perPageMax = 100;
const page = Math.max(parseInt(req.query.page || "1", 10), 1);
let perPage = parseInt(req.query.per_page || String(perPageDefault), 10);
if (Number.isNaN(perPage)) perPage = perPageDefault;
perPage = Math.min(Math.max(perPage, 1), perPageMax);
const offset = (page - 1) * perPage;
const client = await pool.connect();
try {
const { rows } = await client.query(
`
SELECT id, title, created_at
FROM articles
ORDER BY created_at DESC, id DESC
LIMIT $1 OFFSET $2
`,
[perPage, offset]
);
// (اختیاری) شمارش کل - برای جداول بزرگ گران است
// const { rows: countRows } = await client.query("SELECT COUNT(*) FROM articles");
// const total = parseInt(countRows[0].count, 10);
res.json({
data: rows,
page: {
page,
per_page: perPage,
// total, // در صورت نیاز
hasNext: rows.length === perPage // تقریبی
}
});
} catch (e) {
res.status(500).json({ error: "server_error" });
} finally {
client.release();
}
});
app.listen(3000);مزیت: پیاده سازی بسیار ساده. محدودیت: برای page های بزرگ کند می شود.
Cursor را به صورت base64 از جفت created_at و id می سازیم تا پایدار و امن باشد.
import express from "express";
import { Pool } from "pg";

const app = express();
const pool = new Pool({ connectionString: process.env.DATABASE_URL });

const MAX_LIMIT = 100;
const DEFAULT_LIMIT = 50;

function encodeCursor(createdAt, id) {
  return Buffer.from(`${createdAt.toISOString()}:${id}`).toString("base64url");
}

function decodeCursor(cursor) {
  const raw = Buffer.from(cursor, "base64url").toString("utf8");
  const [iso, idStr] = raw.split(":");
  const createdAt = new Date(iso);
  const id = parseInt(idStr, 10);
  if (!iso || Number.isNaN(id) || isNaN(createdAt.getTime())) {
    throw new Error("invalid_cursor");
  }
  return { createdAt, id };
}

app.get("/articles", async (req, res) => {
  let limit = parseInt(req.query.limit || String(DEFAULT_LIMIT), 10);
  if (Number.isNaN(limit)) limit = DEFAULT_LIMIT;
  limit = Math.min(Math.max(limit, 1), MAX_LIMIT);

  const cursor = req.query.cursor ? String(req.query.cursor) : null;

  const client = await pool.connect();
  try {
    let params = [limit + 1]; // یک رکورد اضافه برای تشخیص hasNext
    let where = "";
    if (cursor) {
      const { createdAt, id } = decodeCursor(cursor);
      params = [createdAt.toISOString(), id, limit + 1];
      where = `WHERE (created_at < $1) OR (created_at = $1 AND id < $2)`;
    }

    const { rows } = await client.query(
      `
      SELECT id, title, created_at
      FROM articles
      ${where}
      ORDER BY created_at DESC, id DESC
      LIMIT $${params.length}
      `,
      params
    );

    const hasNext = rows.length > limit;
    const pageRows = hasNext ? rows.slice(0, limit) : rows;

    const nextCursor = hasNext
      ? encodeCursor(pageRows[pageRows.length - 1].created_at, pageRows[pageRows.length - 1].id)
      : null;

    // Link header اختیاری
    if (nextCursor) {
      // نمونه فرمت:
      // Link: </articles?cursor=<cursor>&limit=<limit>>; rel="next"
      res.setHeader("Link", `</articles?cursor=${nextCursor}&limit=${limit}>; rel="next"`);
    }

    res.json({
      data: pageRows,
      page: {
        limit,
        nextCursor,
        hasNext
      }
    });
  } catch (e) {
    const code = e.message === "invalid_cursor" ? 400 : 500;
    res.status(code).json({ error: e.message });
  } finally {
    client.release();
  }
});

app.listen(3000);
نکات کلیدی این پیاده سازی:
import express from "express";
import mongoose from "mongoose";

const app = express();
const Article = mongoose.model("Article", new mongoose.Schema({
  title: String
}, { timestamps: { createdAt: "created_at", updatedAt: "updated_at" } }));

const MAX_LIMIT = 100;
const DEFAULT_LIMIT = 50;

function encode(id) { return Buffer.from(String(id)).toString("base64url"); }
function decode(c) { return new mongoose.Types.ObjectId(Buffer.from(c, "base64url").toString("utf8")); }

app.get("/articles", async (req, res) => {
  let limit = parseInt(req.query.limit || String(DEFAULT_LIMIT), 10);
  if (Number.isNaN(limit)) limit = DEFAULT_LIMIT;
  limit = Math.min(Math.max(limit, 1), MAX_LIMIT);

  const cursor = req.query.cursor ? decode(String(req.query.cursor)) : null;

  const filter = cursor ? { _id: { $lt: cursor } } : {};
  const docs = await Article.find(filter)
    .sort({ _id: -1 })
    .limit(limit + 1)
    .lean();

  const hasNext = docs.length > limit;
  const pageDocs = hasNext ? docs.slice(0, limit) : docs;
  const nextCursor = hasNext ? encode(pageDocs[pageDocs.length - 1]._id) : null;

  res.json({ data: pageDocs, page: { limit, nextCursor, hasNext } });
});

app.listen(3000);
در MongoDB چون _id شامل زمان است، مرتب سازی نزولی روی _id رفتار cursor-دوست ایجاد می کند.
قبل از توسعه همه اندپوینت ها، یک قرارداد واحد برای Pagination انتخاب و در یک ماژول مشترک پیاده سازی کنید. سپس آن را روی پرمصرف ترین پرس و جوها اجرا و با لاگ زمان اجرا، ایندکس ها را بهینه کنید. در نهایت مستندات کوتاه اما دقیق پارامترها و پاسخ را کنار نمونه درخواست/پاسخ منتشر کنید.

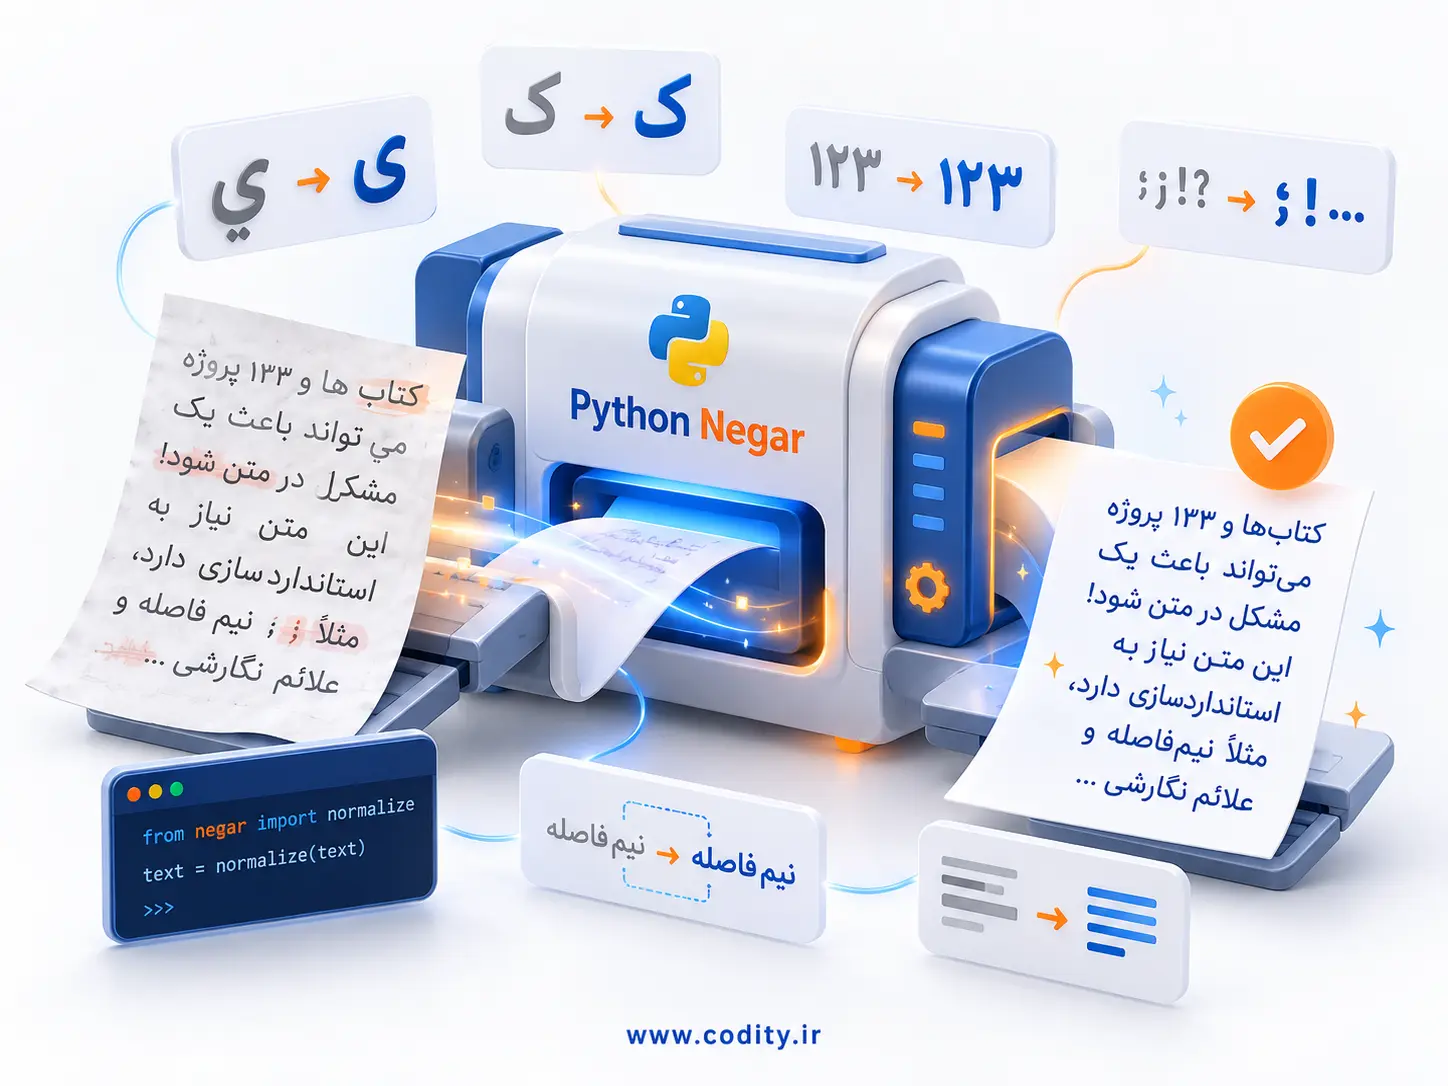
Python Negar یک کتابخانه متن باز برای ویرایش و استانداردسازی متن فارسی در پایتون است که خطاهای رایج نویسه ها، فاصله گذاری، اعداد...
OAuth 2.0 یک چارچوب استاندارد برای مجوزدهی است که به برنامه ها اجازه می دهد بدون دریافت رمز عبور کاربر، به بخش مشخصی...
Webhook چیست؟ یک فراخوانی HTTP یک طرفه است که وقتی رویدادی در نرم افزار A رخ می دهد، همان لحظه یک درخواست POST...
اگر می خواهی یک ایجنت هوش مصنوعی بتواند به جای جستجوی دستی در دیوار، آگهی ها را پیدا کند، قیمت ها را مقایسه...
اگر ایده یک وب سایت، داشبورد یا ابزار سبک داری اما نمی خواهی از همان ابتدا درگیر کدنویسی، هاست و انتشار شوی، ChatGPT...