هیچ محصولی در سبد خرید نیست.
7دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
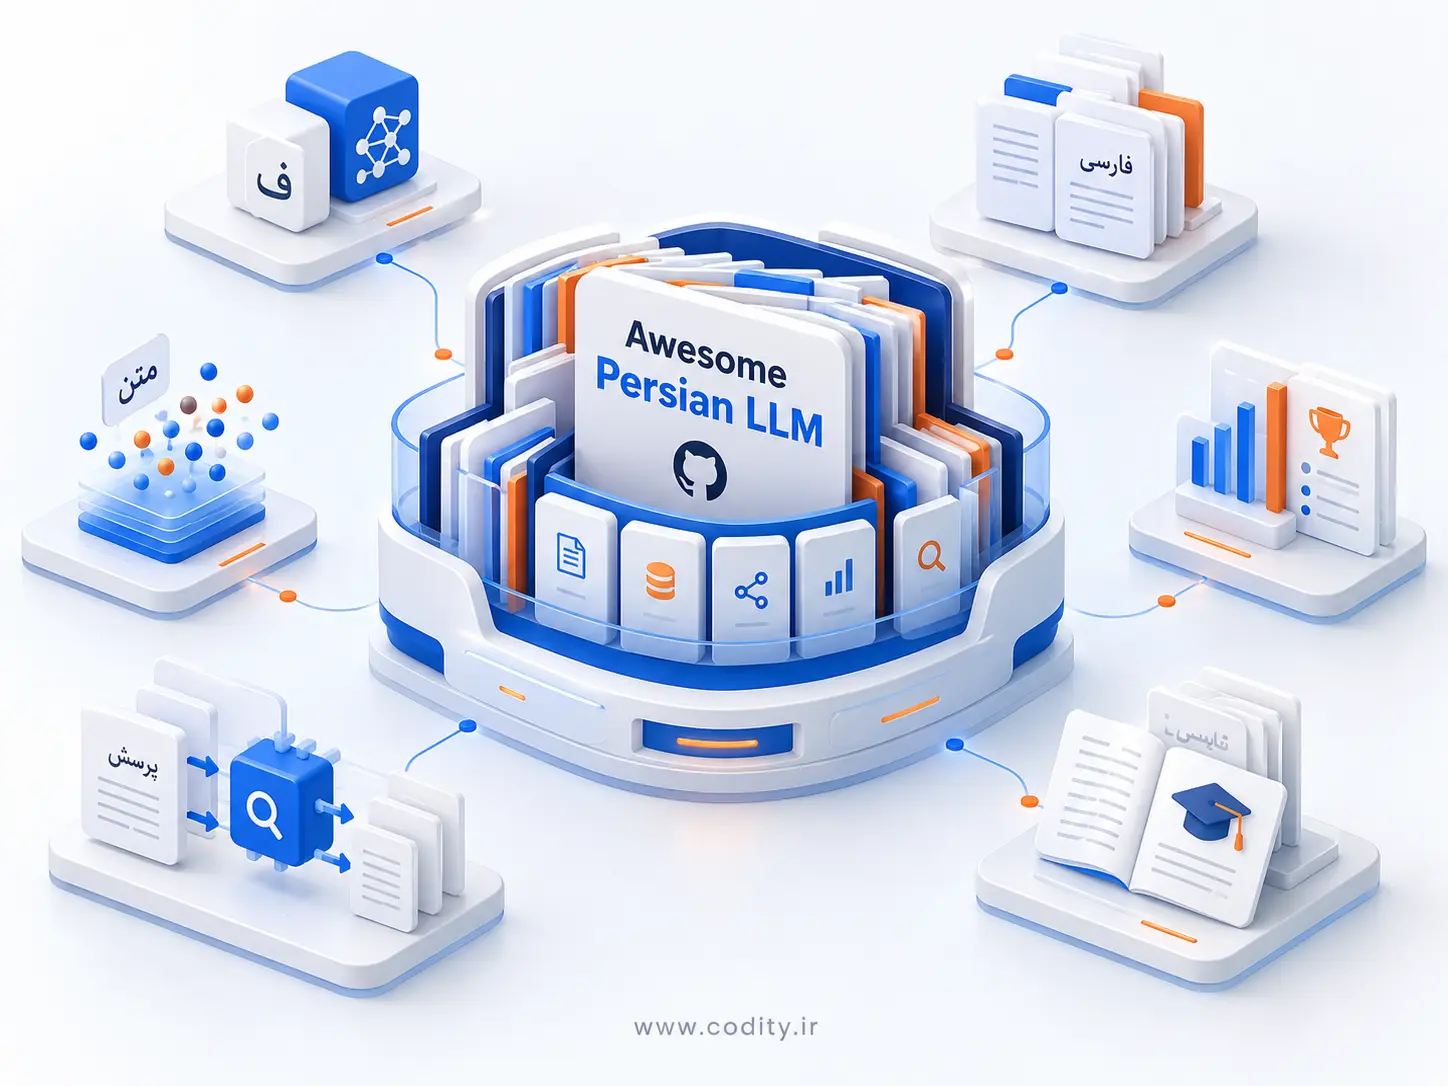
Awesome Persian LLM یک مخزن متن باز در گیت هاب است که منابع مرتبط با مدل های زبانی بزرگ فارسی را در یک فهرست دسته بندی شده جمع آوری می کند. این پروژه که توسط MohammadHeydari ایجاد شده، لینک مقاله های پژوهشی، مدل های منتشرشده، دیتاست ها، ابزارهای توسعه، بنچمارک ها و پلتفرم های مرتبط را در اختیار برنامه نویسان و پژوهشگران قرار می دهد. این مخزن خودش مدل یا چت بات قابل اجرا نیست. هدف آن ساده تر کردن پیدا کردن منابع مناسب برای آموزش، ارزیابی و توسعه سامانه های هوش مصنوعی فارسی است.
بخش بزرگی از پژوهش ها و ابزارهای هوش مصنوعی ابتدا برای زبان انگلیسی توسعه پیدا می کنند. زبان فارسی با تفاوت های نوشتاری، ساختار دستوری و داده های پراکنده، هنگام آموزش و ارزیابی مدل ها چالش های جداگانه ای دارد. پیدا کردن منابع مناسب معمولا به جستجو در چند سایت نیاز دارد.
این مخزن مسیر جستجو را کوتاه تر می کند و نقطه شروع مشترکی می سازد. حضور در فهرست به معنی تایید کیفیت یا مجوز منابع نیست.
بخش اصلی پروژه فایل README است که لینک ها را زیر عنوان های مشخص نمایش می دهد. دسته های پژوهش و مقاله، مدل ها، مجموعه داده ها، مخازن کاربردی، ارزیابی و بنچمارک، سرویس های API و مطالب آموزشی در این فایل دیده می شوند. بخش پژوهش نیز به موضوعاتی مانند آموزش مدل، تنظیم دستورپذیری، بازیابی اطلاعات، فرهنگ و زبان شناسی تقسیم شده است.
این ساختار کمک می کند توسعه دهنده متناسب با هدف خود حرکت کند. کسی که به دنبال مدل آماده است مستقیم به بخش Models می رود و پژوهشگری که می خواهد عملکرد یک مدل را بسنجد از بخش Benchmarks شروع می کند.
در بخش Models نام هایی مانند Dorna-Llama3، PersianMind، AVA-Llama-3-V2، Maral-7B، gemma3persian و نسخه هایی از Persian Llama دیده می شود. لینک برخی مدل ها به Hugging Face و برخی به بسترهایی مانند Ollama هدایت می شوند. این فهرست صرفا مسیر دسترسی به پروژه هاست و مدل ها لزوما معماری، اندازه، کیفیت یا شرایط اجرای یکسانی ندارند.
برای انتخاب مدل باید کارت مدل، نوع داده آموزشی، پشتیبانی از دستور فارسی، نیاز سخت افزاری و مجوز انتشار آن را خواند. نام فارسی یک مدل نیز تضمین کننده عملکرد بهتر نیست.
بخش Datasets منابعی مانند Persian Poetry Dataset، Persian News Dataset، Targoman TLPC و Persian-Synthetic-Instruct را معرفی می کند. همچنین مجموعه هایی برای مکالمه، بازیابی اطلاعات و سوال و جواب فارسی در فهرست وجود دارند. چنین تنوعی برای پروژه هایی اهمیت دارد که به داده عمومی متنی، دستورهای آموزشی یا محتوای تخصصی نیاز دارند.
در بخش پژوهش، Matina نیز به عنوان یک پیکره بزرگ متن فارسی با عنوان ۷۳ میلیارد توکن معرفی شده است. تعداد توکن به تنهایی کیفیت داده را نشان نمی دهد. پیش از آموزش مدل باید منبع، کیفیت و محدودیت های حقوقی داده بررسی شوند.
مدل زبانی را نمی توان تنها بر اساس روان بودن چند پاسخ انتخاب کرد. آزمون های استاندارد کمک می کنند توانایی مدل در استدلال، دانش عمومی، فهم زبان یا وظایف تخصصی با روش مشخص تری سنجیده شود. این مخزن لینک Open Persian LLM Leaderboard، Persian LLM Leaderboard، MIZAN و ParsBench را در بخش ارزیابی گردآوری کرده است.
مقاله های پژوهشی مرتبط با PersianMMLU، MELAC، ELAB و PerCoR نیز در بخش تحقیقات قرار دارند. مقایسه امتیازها بدون توجه به نسخه آزمون، تنظیمات و احتمال آلودگی داده آموزشی می تواند گمراه کننده باشد.
همه منابع معرفی شده مدل تولید متن نیستند. بخش Embedding Models به گزینه هایی مانند Hakim و Tooka-SBERT اشاره می کند. این مدل ها متن را به نمایش برداری تبدیل می کنند تا بتوان شباهت معنایی جمله ها یا اسناد را محاسبه کرد. این قابلیت برای جستجوی مفهومی و بازیابی اطلاعات مفید است.
همچنین FaMTEB به عنوان مرجع ارزیابی Embedding فارسی معرفی شده است. هنگام انتخاب مدل برداری بهتر است عملکرد آن روی عبارت های واقعی پروژه، سرعت پردازش و هزینه نگهداری بردارها را بسنجی. عملکرد مدل برای حوزه های متنی مختلف یکسان نیست.
در سامانه RAG، مدل پیش از تولید پاسخ، اطلاعات مرتبط را از یک منبع خارجی بازیابی می کند. این روش در ساخت دستیار مبتنی بر اسناد شرکت، پایگاه دانش یا سوالات پرتکرار مفید است. فهرست پروژه شامل پژوهش هایی مانند PersianRAG، FARSIQA و TekRAG-Persian است. مخازنی مرتبط با LangChain، ویکی پدیا و نمونه های چت بات فارسی نیز معرفی شده اند.
برای ساخت یک RAG دقیق باید علاوه بر انتخاب مدل زبانی، کیفیت استخراج متن، قطعه بندی اسناد، Embedding و ارزیابی پاسخ را در نظر گرفت. پروژه نمونه لزوما آماده محیط تولید نیست.
درک فارسی فقط به تشخیص واژه ها محدود نیست. ترجمه اصطلاحات، تفاوت زبان رسمی و محاوره ای و رفتارهای فرهنگی می توانند روی کیفیت مدل اثر بگذارند. مخزن مقاله هایی درباره تعارف فارسی، ترجمه اصطلاحات فارسی و انگلیسی و تفاوت های فارسی، دری و تاجیکی را نیز گردآوری کرده است.
این منابع به ویژه برای ساخت دستیارهای گفتگو و محصولات چندزبانه اهمیت دارند. مدلی که جمله را از نظر دستوری درست تولید می کند، ممکن است لحن مناسب یا معنی فرهنگی آن را درست متوجه نشود. ارزیابی روی گفتگوی واقعی کاربران می تواند چنین ضعف هایی را آشکار کند.
بخش Repos به پروژه هایی برای اجرای مدل با Ollama، تولید داده مصنوعی، آزمایش QLoRA و پیاده سازی RAG اشاره دارد. همچنین در بخش APIs & Platforms نام سرویس هایی مانند AvvalAI، GapGPT، Liara، Roboo و Ivira آمده است. این موارد نقش یکسان ندارند؛ بعضی محیط اجرای مدل یا خدمات API فراهم می کنند و بعضی نمونه کد یا زیرساخت توسعه هستند.
پیش از انتخاب هر سرویس باید مدل های پشتیبانی شده، شرایط داده، قیمت، محدودیت درخواست و مستندات آن را مستقلا بررسی کرد. فهرست گیت هاب جایگزین ارزیابی فنی و قراردادی ارائه دهنده نیست.
برای شروع به نشانی گیت هاب پروژه برو و بخش مربوط به نیاز خود را در README باز کن. اگر هدف ساخت چت بات فارسی است، ابتدا چند مدل از بخش Models انتخاب کن و کارت آن ها را مطالعه کن. سپس مجموعه داده یا اسناد مناسب را مشخص و برای ارزیابی چند سوال واقعی طراحی کن.
اگر قصد Fine-tuning داری، کیفیت و مجوز دیتاست را پیش از دانلود بررسی کن. برای پروژه جستجوی اسناد، از بخش Embedding و RAG آغاز کن. نسخه مدل و نتیجه آزمایش را ثبت کن.
این پروژه یک فهرست گردآوری شده است، نه سامانه تایید کیفیت یا رتبه بندی مستقل همه منابع. بعضی لینک ها ممکن است در آینده تغییر کنند، مدل ها ممکن است به روزرسانی شوند و شرایط استفاده از داده ها یکسان نیست. توضیح تبلیغاتی مدل نیز جایگزین آزمایش مستقل نیست.
هنگام استفاده از داده های واقعی باید منشا داده، اطلاعات شخصی احتمالی و امکان استفاده تجاری را بررسی کرد. کیفیت و امنیت باید روی داده واقعی آزموده شوند.
توسعه دهنده پروژه امکان مشارکت عمومی را فراهم کرده است. اگر مقاله، مدل یا دیتاست مرتبطی پیدا کنی که در فهرست وجود ندارد، می توانی مخزن را Fork کنی، منبع را در دسته مناسب قرار دهی و Pull Request بفرستی. این روش به تکمیل منابع مدل های زبانی فارسی و آسان تر شدن دسترسی جامعه پژوهشی کمک می کند.
طبق README، خود پروژه تحت مجوز MIT منتشر شده است. این مجوز به صورت خودکار به مدل ها، مقالات یا دیتاست های پیوند داده شده منتقل نمی شود. برای بازنشر یا استفاده تجاری از هر منبع باید مجوز همان منبع را جداگانه بررسی کرد.
Awesome Persian LLM نقطه شروع مناسبی برای شناخت اکوسیستم مدل های زبانی فارسی است. این مخزن مدل های آماده، دیتاست های متنی، پژوهش های دانشگاهی، بنچمارک های ارزیابی و پروژه های RAG را در کنار هم قرار داده و زمان یافتن منابع مرتبط را کاهش می دهد. مزیت اصلی آن ساختن یک مسیر منظم برای تحقیق و انتخاب ابزار است، نه ارائه یک مدل یا سرویس اجرایی مستقل.
برای استفاده موثر، ابتدا نیاز پروژه را مشخص کن، سپس منابع مرتبط را از فهرست پیدا کن و هر گزینه را از نظر کیفیت، مجوز و عملکرد واقعی بسنج. این رویکرد انتخاب مدل را قابل دفاع تر می کند.

برای ساخت تقویم محتوایی با هوش مصنوعی، از مدل زبانی برای استخراج ایدهها بر اساس مخاطب و محصول شروع کنید، کلمات کلیدی را...
Muse Wonder Full پیشرفته ترین مدل خانواده Wonder شرکت متا است که در ۱۲ اکتبر ۲۰۲۶ برای استدلال پیچیده، برنامه نویسی حرفه ای...
Muse AI Agent فقط یک ابزار گفتگو نیست و می تواند برای مدیریت ایمیل ها، برنامه ریزی روزانه، تحقیق اینترنتی، خرید آنلاین و...
Muse Wonder مدل جدید هوش مصنوعی متا است که در ۱۲ اکتبر ۲۰۲۶ برای ساخت ایجنت های شخصی و حرفه ای معرفی شد....
اگر به دنبال ساخت سریع تصویر و وکتورهای قابل ویرایش هستید، آموزش Recraft AI دقیقا به شما نشان می دهد چطور با یک...