هیچ محصولی در سبد خرید نیست.
8دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
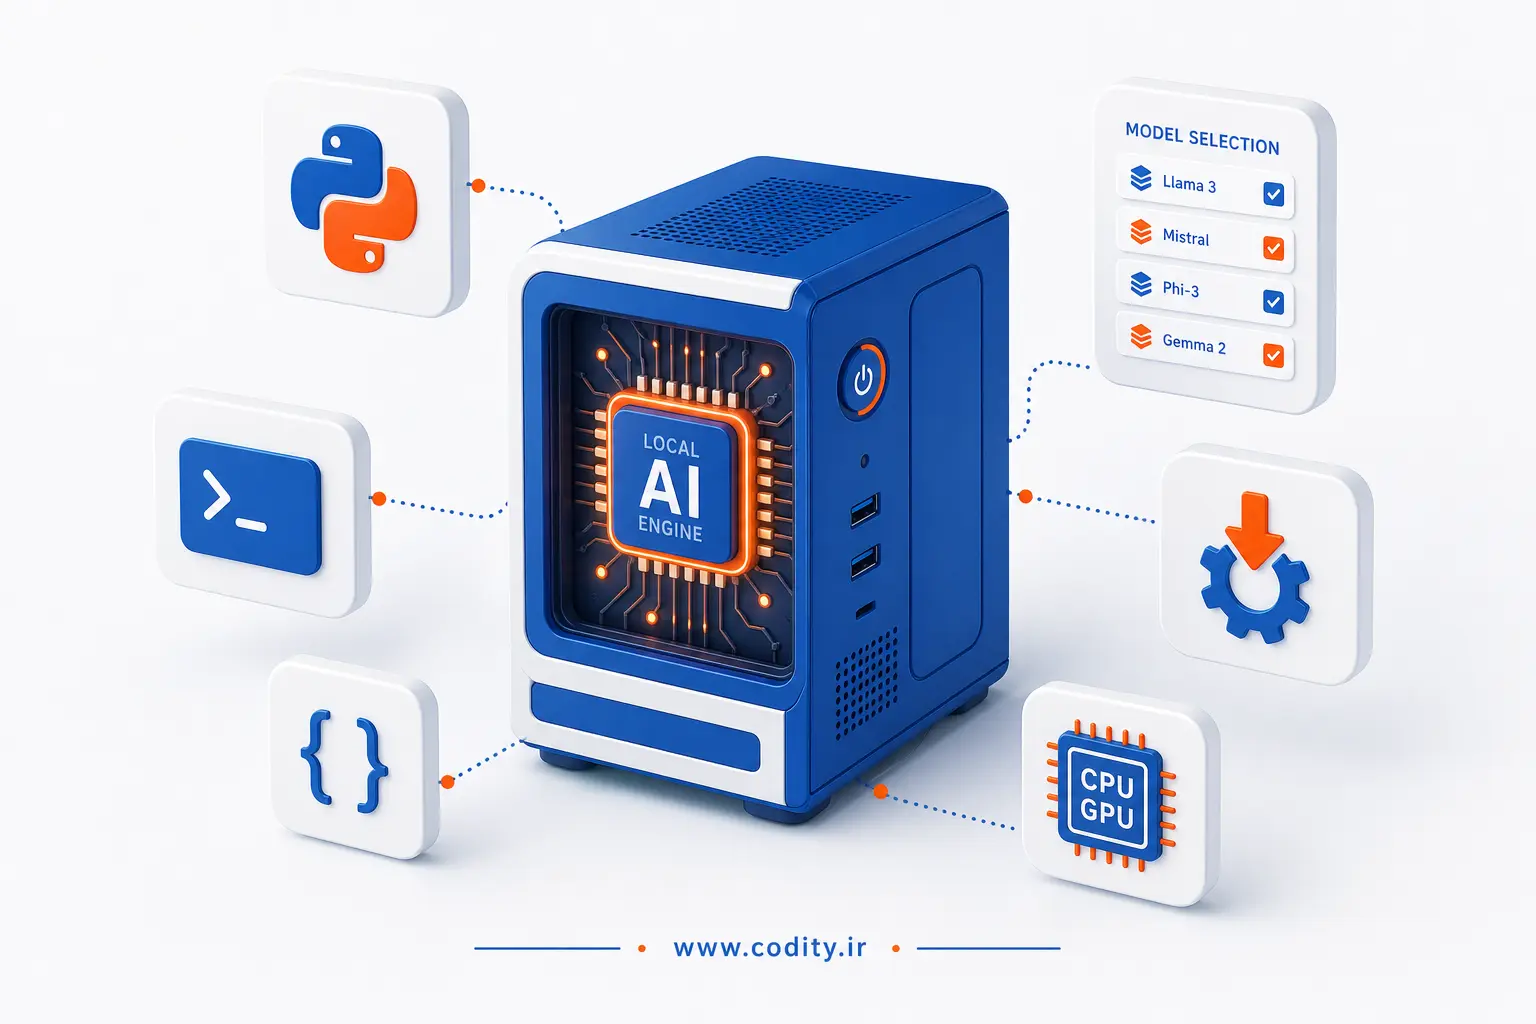
اگر دنبال آموزش Ollama هستید، مسیر سریع این است: برنامه را نصب کنید، یک مدل مناسب مثل llama3:8b را با دستور ollama pull بگیرید، با ollama run تست کنید و سپس از طریق REST API یا کتابخانه پایتون ollama در کد خود استفاده کنید. تمام این روند روی سیستم شخصی انجام میشود و نیازی به سرور ابری ندارد.
localhost:11434 سرویس میدهد. دادهها از سیستم شما خارج نمیشوند مگر اینکه خودتان در کد مقصد خارجی تنظیم کنید.بهترین مرجع نصب، وبسایت رسمی Ollama است. اگر ترجیح میدهید از خط فرمان استفاده کنید، این روشهای متداول را ببینید:
winget install Ollama.Ollama
# پس از نصب، سرویس معمولا خودکار اجرا میشود
# برای اطمینان:
ollama --version
brew install ollama
# اجرا کردن سرویس
ollama serve
# پنجره را باز نگه دارید یا سرویس را به صورت background اجرا کنید
curl -fsSL https://ollama.com/install.sh | sh
# سپس:
ollama serve
برای بررسی اجرا بودن سرویس، این دستورها باید بدون خطا پاسخ دهند:
ollama --version
curl http://localhost:11434/api/tags
ollama run اجرا و تست کنید.# نمونه: مدل عمومی برای گفتگو
ollama pull llama3:8b
# اجرا و تعامل تعاملی
ollama run llama3:8b
# برای خروج از محیط تعاملی:
# تایپ کنید: /bye یا Ctrl+C
چند دستور کاربردی دیگر:
# دیدن مدلهای موجود در سیستم
ollama list
# حذف یک مدل
ollama rm llama3:8b
اگر دنبال مدلهای مناسب کدنویسی هستید، نسخههای Instruct یا Coder از خانوادههایی مثل Llama یا Mistral انتخابهای رایجی هستند. برای آشنایی با زیستبوم مدلها و مخازن آنها، راهنمای Hugging Face چیست؟ پلتفرم مدل های هوش مصنوعی دید کلی خوبی میدهد.
اگر به دنبال یک مسیر یادگیری منسجم در ابزارها و مدلهای مختلف هستید، دوره آموزش جامع ابزارهای هوش مصنوعی (Ai Master) روند انتخاب و به کارگیری ابزارها را با تمرکز کاربردی پوشش میدهد.
میتوانید از REST API داخلی Ollama یا کتابخانه پایتون ollama استفاده کنید. هر دو روی http://localhost:11434 کار میکنند.
برای یک درخواست یکجای غیر استریم، stream: false بگذارید تا پاسخ کامل را یکجا بگیرید.
import requests
url = "http://localhost:11434/api/chat"
payload = {
"model": "llama3:8b",
"messages": [
{"role": "system", "content": "You are a helpful assistant. پاسخها را به فارسی بده."},
{"role": "user", "content": "دو مزیت اجرای مدل به صورت محلی چیست؟"}
],
"stream": False
}
resp = requests.post(url, json=payload, timeout=180)
resp.raise_for_status()
data = resp.json()
print(data["message"]["content"])
اگر پاسخ مرحلهای و زنده میخواهید، از استریم استفاده کنید و هر خط JSON را پردازش کنید:
import requests, json

url = "http://localhost:11434/api/generate"
payload = {
    "model": "llama3:8b",
    "prompt": "در یک پاراگراف کوتاه، کاربرد خلاصه سازی متن را توضیح بده.",
    "stream": True
}

with requests.post(url, json=payload, stream=True) as r:
    r.raise_for_status()
    for line in r.iter_lines():
        if not line:
            continue
        chunk = json.loads(line.decode("utf-8"))
        if "response" in chunk:
            print(chunk["response"], end="", flush=True)
        if chunk.get("done"):
            break
print("\n-- done --")
اگر با خطای اتصال مواجه شدید، بررسی کنید سرویس در حال اجرا است: ollama serve یا از طریق اپ گرافیکی.
کتابخانه رسمی پایتون برای کار با Ollama تجربهای سادهتر ارائه میدهد.
pip install ollama
import ollama
# گفتگوی ساده
res = ollama.chat(
model="llama3:8b",
messages=[
{"role": "system", "content": "پاسخها را کوتاه و فارسی بده."},
{"role": "user", "content": "Ollama چه کاربردی دارد؟"}
]
)
print(res["message"]["content"])
# تولید متن با پرامپت یکخطی
gen = ollama.generate(model="llama3:8b", prompt="سه مورد استفاده از LLM در نرمافزار را نام ببر.")
print(gen["response"])
برای جاسازی متن (در صورت پشتیبانی مدل انتخابی):
from ollama import Client

client = Client(host="http://localhost:11434")
emb = client.embeddings(model="nomic-embed-text", prompt="این یک متن نمونه برای embedding است.")
print(len(emb["embedding"]))  # طول بردار embedding
هدف: یک فایل متنی را بخوانیم، در چند بخش به مدل بدهیم و خلاصه نهایی بگیریم.
import requests, textwrap, json
MODEL = "llama3:8b"
API = "http://localhost:11434/api/chat"
def chunk(text, size=2000):
for i in range(0, len(text), size):
yield text[i:i+size]
def summarize_section(text):
payload = {
"model": MODEL,
"messages": [
{"role": "system", "content": "تو یک ابزار خلاصه ساز هستی. خلاصه را به فارسی و نکتهوار بده."},
{"role": "user", "content": f"این بخش را خلاصه کن:\n\n{text}"}
],
"stream": False
}
r = requests.post(API, json=payload, timeout=180)
r.raise_for_status()
return r.json()["message"]["content"].strip()
if __name__ == "__main__":
with open("article.txt", "r", encoding="utf-8") as f:
content = f.read()
partial_summaries = [summarize_section(c) for c in chunk(content, 2500)]
joined = "\n".join(f"- {s}" for s in partial_summaries)
final_payload = {
"model": MODEL,
"messages": [
{"role": "system", "content": "خلاصه نهایی یکدست، کوتاه و فارسی باشد."},
{"role": "user", "content": f"اینها خلاصههای میانی هستند، آنها را یک خروجی نهایی منسجم کن:\n{joined}"}
],
"stream": False
}
final = requests.post(API, json=final_payload, timeout=180).json()
print("\nخلاصه نهایی:\n")
print(textwrap.fill(final["message"]["content"], 100))
در فایلهای بلند، تقسیم متن به بخشهای کوچکتر از سرریز حافظه و بافر جلوگیری میکند و کیفیت جمعبندی را بالا میبرد.
اگر میخواهید یک نسخه سفارشی با System Prompt و پارامترهای دلخواه داشته باشید، یک Modelfile بسازید:
# Modelfile
# فایل را با همین نام ذخیره کنید
FROM llama3:8b
PARAMETER temperature 0.7
PARAMETER num_ctx 8192
SYSTEM پاسخها را به فارسی، دقیق و مختصر ارائه بده.
# ساخت مدل سفارشی
ollama create my-llama-fa -f Modelfile

# اجرا
ollama run my-llama-fa
با افزایش num_ctx (طول پنجره متن)، حافظه بیشتری مصرف میشود. اگر با کندی یا خطا مواجه شدید، مقدار را پایین بیاورید.
ollama run llama3:8b را اجرا و یک پرسش کوتاه مطرح کنید.curl http://localhost:11434/api/tags باید JSON معتبر باشد.stream: false بفرستید و متن پاسخ را چاپ کنید.11434 آزاد نیست، برنامه متناقض را ببندید یا سرویس را روی پورت دیگر اجرا کنید و در کلاینت همان پورت را تنظیم کنید.ollama pull را دوباره اجرا کنید. اتصال اینترنت و فضای دیسک را بررسی کنید.pull کنید و در محیط staging تاثیر آن بر کیفیت و منابع را بسنجید.اگر به موضوع ایجنتها و مدلهای تازه علاقه دارید، معرفی Muse Wonder Full چیست؟ مدل متا برای استدلال و Agentها دید خوبی از روندهای جدید میدهد و در انتخاب نقشه راه کمک میکند.
یک مدل سبک 7B را نصب و اجرا کنید، یک اسکریپت پایتون کوتاه بنویسید و فرآیند پرسش و پاسخ یا خلاصه سازی را انتها به انتها بسنجید. وقتی جریان پایه پایدار شد، سراغ مدلهای تخصصی کدنویسی، تنظیم پارامترها و Modelfile بروید تا کیفیت و سرعت را متناسب با نیاز خودتان بهینه کنید.

اگر هدف شما آموزش هوش مصنوعی از صفر است، مسیر شروع ساده است: پایتون و مبانی آمار و جبر خطی را جمع بندی...
Awesome Persian LLM یک مخزن متن باز در گیت هاب است که منابع مرتبط با مدل های زبانی بزرگ فارسی را در یک...
برای ساخت تقویم محتوایی با هوش مصنوعی، از مدل زبانی برای استخراج ایدهها بر اساس مخاطب و محصول شروع کنید، کلمات کلیدی را...
Muse Wonder Full پیشرفته ترین مدل خانواده Wonder شرکت متا است که در ۱۲ اکتبر ۲۰۲۶ برای استدلال پیچیده، برنامه نویسی حرفه ای...
Muse AI Agent فقط یک ابزار گفتگو نیست و می تواند برای مدیریت ایمیل ها، برنامه ریزی روزانه، تحقیق اینترنتی، خرید آنلاین و...