هیچ محصولی در سبد خرید نیست.
7دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
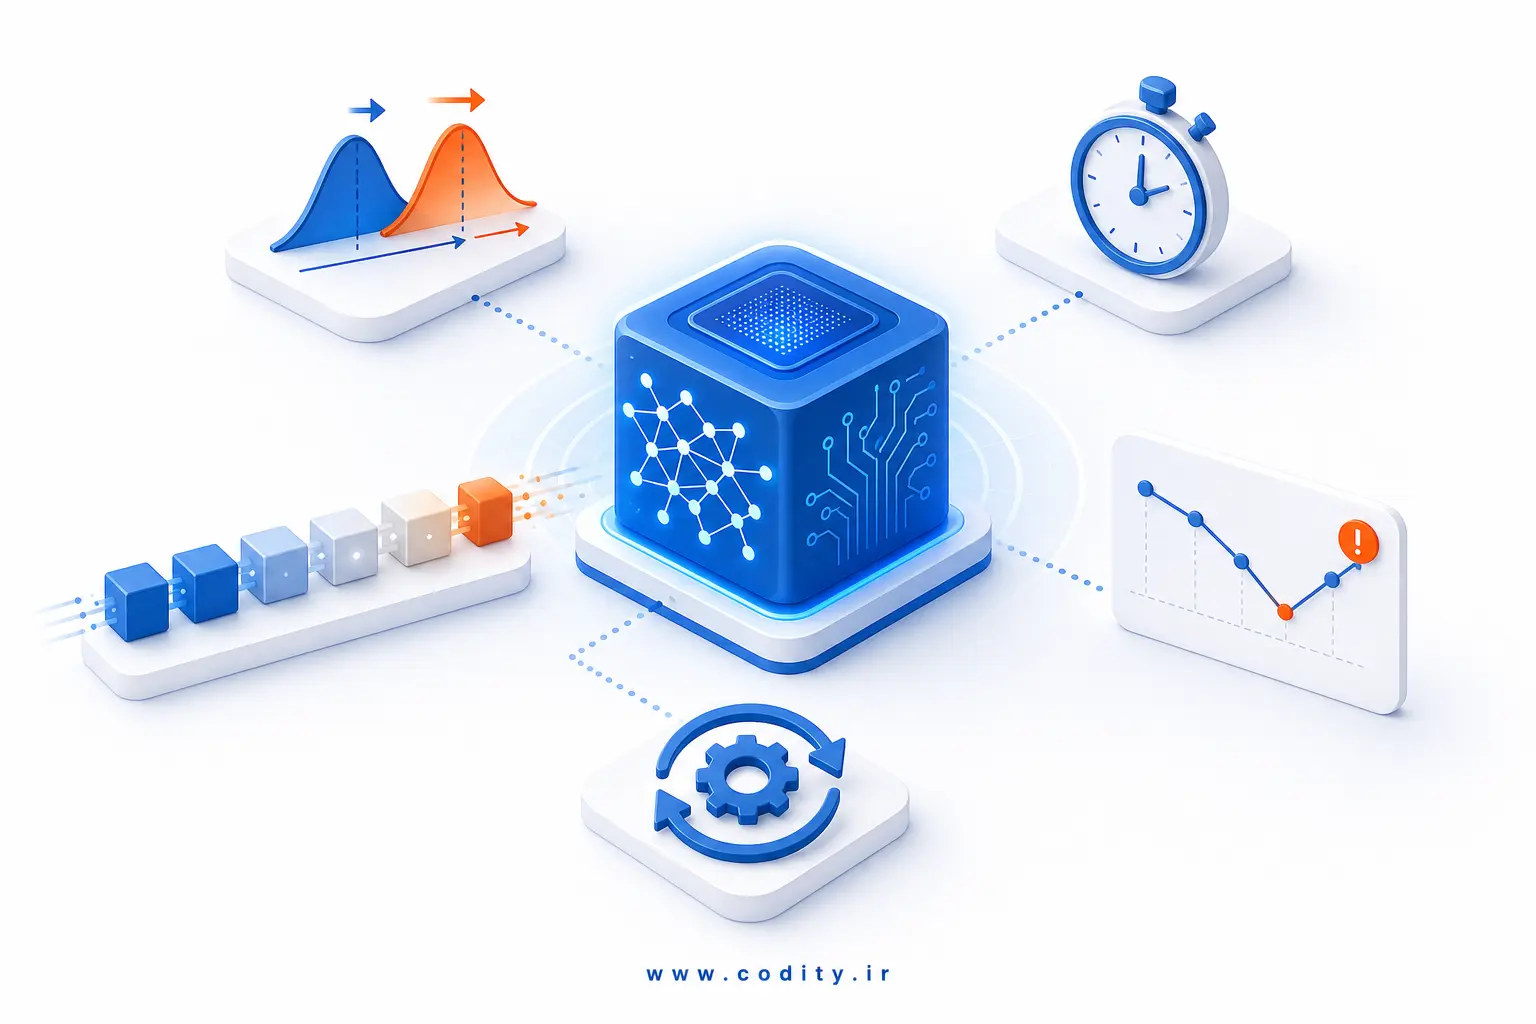
پاسخ کوتاه: Concept Drift چیست؟ تغییری در رابطه آماری بین ورودیها و خروجی هدف در گذر زمان که باعث میشود مدلی که روی دادههای گذشته خوب بوده، بعد از مدتی دقت خود را از دست بدهد. این افت معمولا به خاطر تغییر رفتار کاربران یا بازار، فصلها و رویدادها، تغییر در نحوه جمع آوری داده یا حتی تاثیر خود تصمیمهای مدل رخ میدهد. راه حل، پایش مستمر، تشخیص به موقع و به روزرسانی کنترل شده مدل است؛ از بازآموزی دورهای و پنجره زمانی تا یادگیری آنلاین و بازکالیبراسیون آستانهها.
در یادگیری ماشین ما فرض میکنیم رابطه بین ویژگیها و برچسب هدف پایدار است. Concept Drift یعنی این رابطه تغییر کرده است؛ برای مثال احتمال برنده شدن یک آگهی با همان ویژگیها امروز با ماه قبل فرق دارد. از نظر آماری، سه الگوی مهم وجود دارد:
داده در دنیای واقعی ایستا نیست. هر جا داده تازه میآید یا محیط تصمیم تغییر میکند، خطر درفت وجود دارد.
هیچ تک معیار جادویی وجود ندارد. باید همزمان عملکرد مدل، توزیع داده و کیفیت ورودیها را پایش کنید.
از نشانگرهای جایگزین استفاده کنید: توزیع نمره مدل، نرخ عبور از آستانه، همبستگی نمره با سیگنالهای قابل مشاهده. در داده جریانی، ارزیابی پیشازمانی (prequential) و پنجرههای لغزان کمک میکند.
هدف: نشان دهیم با تغییر توزیع و مفهوم، عملکرد افت میکند؛ سپس با تشخیص درفت و بازآموزی، بخشی از عملکرد برمیگردد. این کد آموزشی است و برای تولید نیاز به سختگیری بیشتری دارد.
import numpy as np
import pandas as pd
from scipy.stats import ks_2samp
from sklearn.linear_model import SGDClassifier
from sklearn.metrics import roc_auc_score
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
np.random.seed(42)

# داده مرجع (گذشته)
n0 = 5000
x1_old = np.random.normal(0.0, 1.0, n0)
x2_old = np.random.normal(0.0, 1.0, n0)
noise0 = np.random.normal(0, 0.5, n0)
y_old = ((x1_old + 0.5 * x2_old + noise0) > 0).astype(int)
X_old = np.c_[x1_old, x2_old]

# داده جدید (حال) با درفت: میانگین x1 تغییر کرده و نقش x2 معکوس شده
n1 = 3000
x1_new = np.random.normal(0.6, 1.0, n1)     # covariate shift
x2_new = np.random.normal(0.0, 1.0, n1)
noise1 = np.random.normal(0, 0.5, n1)
y_new = ((0.5 * x1_new - 1.0 * x2_new + noise1) > 0).astype(int)  # concept shift
X_new = np.c_[x1_new, x2_new]

# آموزش روی گذشته
clf = make_pipeline(StandardScaler(), SGDClassifier(loss="log_loss", random_state=42))
clf.fit(X_old, y_old)

# عملکرد روی گذشته و حال
auc_old = roc_auc_score(y_old, clf.predict_proba(X_old)[:, 1])
auc_new = roc_auc_score(y_new, clf.predict_proba(X_new)[:, 1])
print(f"AUC گذشته: {auc_old:.3f} | AUC حال: {auc_new:.3f} (افت: {auc_old - auc_new:.3f})")

# آزمون KS برای x1 بین گذشته و حال
ks_stat, ks_p = ks_2samp(x1_old, x1_new)
print(f"KS x1: stat={ks_stat:.3f}, p-value={ks_p:.3e}")

# PSI ساده برای x1
def psi(expected, actual, bins=10):
    # بکت سازی بر اساس صدک های بازه مرجع
    qs = np.quantile(expected, np.linspace(0, 1, bins + 1))
    qs[0] -= 1e-9
    qs[-1] += 1e-9
    e_counts, _ = np.histogram(expected, bins=qs)
    a_counts, _ = np.histogram(actual, bins=qs)
    e_ratio = np.clip(e_counts / len(expected), 1e-6, None)
    a_ratio = np.clip(a_counts / len(actual), 1e-6, None)
    return float(np.sum((a_ratio - e_ratio) * np.log(a_ratio / e_ratio)))

psi_x1 = psi(x1_old, x1_new, bins=10)
print(f"PSI x1: {psi_x1:.3f}")

# تصمیم: اگر افت عملکرد یا شواهد آماری قوی باشد، بازآموزی روی پنجره اخیر
drift_alert = (auc_old - auc_new > 0.05) or (ks_p < 0.01) or (psi_x1 > 0.25)
print("هشدار درفت:", drift_alert)

if drift_alert:
    clf.fit(X_new, y_new)  # بازآموزی روی پنجره اخیر
    auc_new_retrained = roc_auc_score(y_new, clf.predict_proba(X_new)[:, 1])
    print(f"AUC پس از بازآموزی روی حال: {auc_new_retrained:.3f}")
چطور نتیجه را بررسی کنیم؟ اجرای کد باید نشان دهد AUC روی داده جدید افت کرده، آزمون KS یا PSI تغییر توزیع را گزارش میکند و با بازآموزی روی پنجره اخیر، AUC روی داده جاری بهتر میشود. در محیط واقعی به جای شبیه سازی، بازه مرجع را ماههای گذشته و بازه جاری را هفته یا روزهای تازه بگیرید.
اگر مدل در تولید دارید، از همین هفته یک داشبورد پایش مشترک برای عملکرد، توزیع ویژگیها و کیفیت داده بسازید و آستانههای هشدار عملی تعریف کنید. سپس یک خط لوله بازآموزی ایمن با پنجره زمانی و کالیبراسیون دورهای پیاده کنید. اگر هنوز در مرحله توسعه هستید، اعتبارسنجی زمانی و حساسیت مدل به سناریوهای درفت را جزو معیارهای پذیرش قرار دهید.

در ارزیابی مدل روی داده نامتوازن، تکیه بر Accuracy معمولا گمراهکننده است؛ چون یک مدل میتواند با حدس زدن همیشگی اکثریت، Accuracy بالا...
ChatGPT Translate ابزار ترجمه مبتنی بر هوش مصنوعی OpenAI است که فقط واژه ها را از یک زبان به زبان دیگر تبدیل نمی...

در دنیای امروز که دادهها به منبع اصلی تصمیمگیری در کسبوکارها تبدیل شدهاند، نقش دانشمند داده یا Data Scientist بسیار حیاتی است. بسیاری...

یادگیری ماشین (Machine Learning) به یکی از پرطرفدارترین حوزههای فناوری تبدیل شده است. اما برای شروع، بسیاری از افراد نمیدانند دقیقاً باید از...

یکی از چالشهای بزرگ در دنیای یادگیری ماشین این است که پروژهها فقط در سطح تحقیق و آزمایش باقی نمانند، بلکه به مرحله...