هیچ محصولی در سبد خرید نیست.
6دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
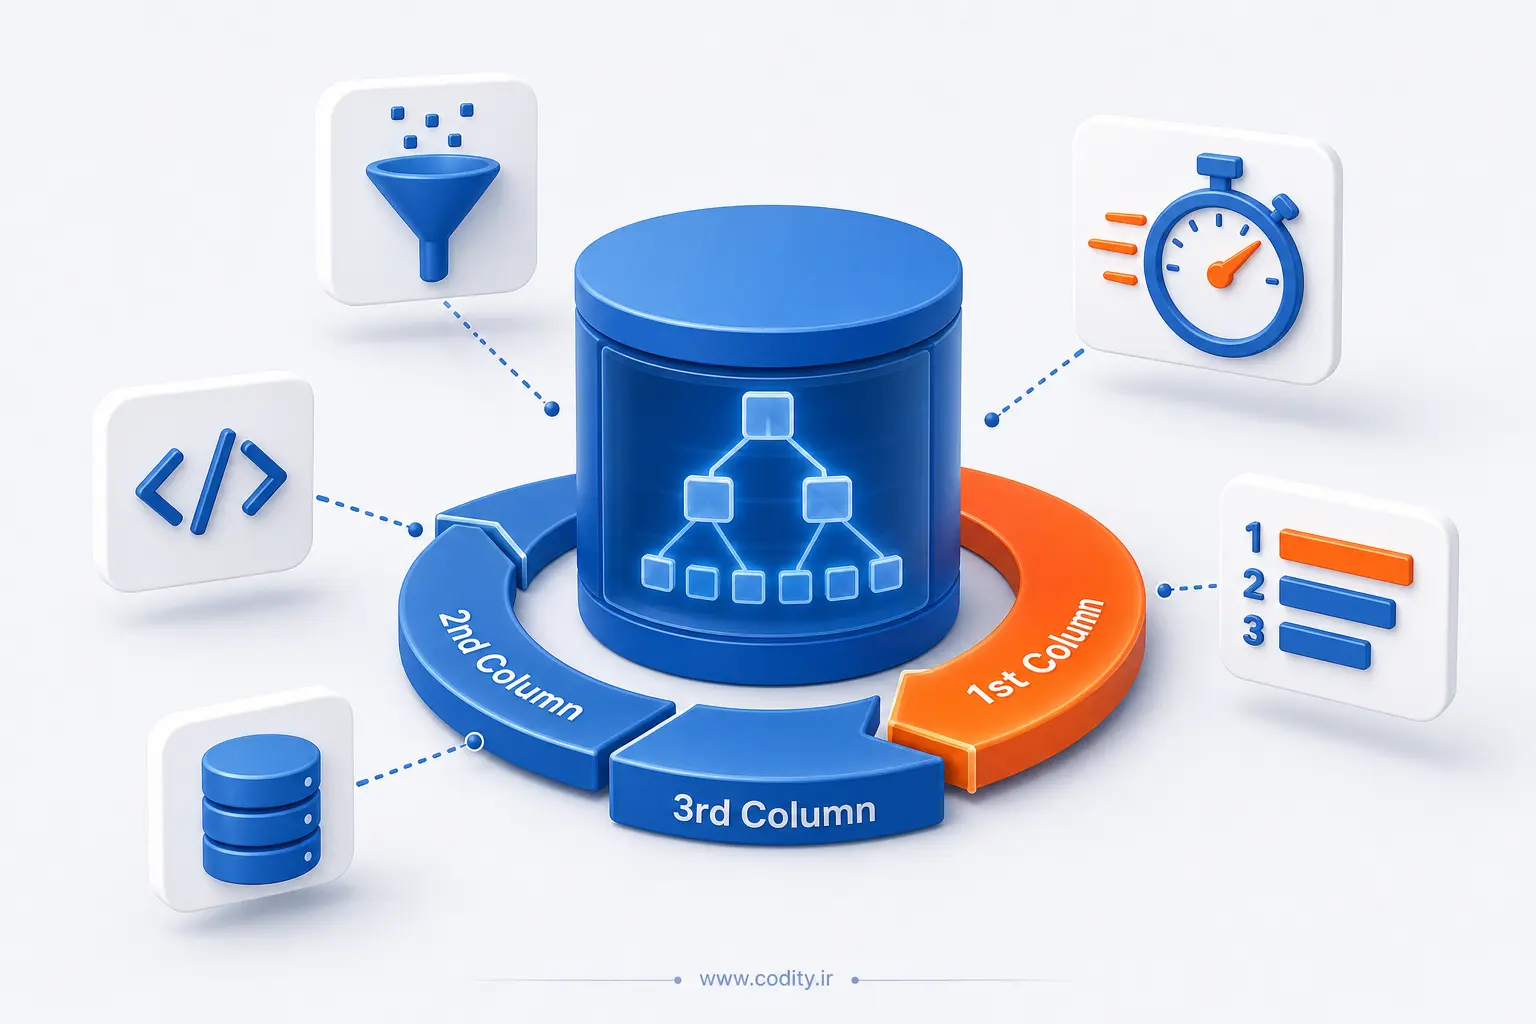
ترتیب ستون ها در Composite Index مستقیما تعیین میکند موتور دیتابیس از چه پیشوندی برای پیمایش ایندکس استفاده کند. اگر این ترتیب با الگوی شرطها و مرتبسازی کوئریهای شما همخوان نباشد، ایندکس یا استفاده نمیشود یا فقط بخشی از آن به کار میآید و سرعت به شکل محسوسی کاهش پیدا میکند. قاعده عملی این است: ستونهای با شرط مساوی و گزینش پذیری بالاتر را جلو بگذارید، بعد ستونهای بازهای، و در صورت نیاز ستونهای مرتبسازی/گروهبندی را در ادامه بیاورید تا اسکن کم و عمل مرتبسازی حذف شود.
در ایندکسهای B-Tree چندستونه، دادهها بر اساس ترتیب تعریفشده از چپ به راست مرتب میشوند. موتور میتواند از هر پیشوند چپ ایندکس برای جستجو استفاده کند؛ مثلا برای ایندکس (a,b,c) این پیشوندها قابل استفادهاند: (a)، (a,b) و (a,b,c). اگر شرط شما روی a مساوی باشد و روی b بازهای، موتور میتواند بسیار سریع همه رکوردهای a=x و سپس محدوده b را پیدا کند. اما اگر ترتیب ایندکس (b,a) باشد، همان شرط به استفاده کامل از ایندکس منجر نمیشود و هزینه اسکن بالا میرود.
جدول سفارشها را در نظر بگیرید:
CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  status VARCHAR(20) NOT NULL,
  created_at TIMESTAMP NOT NULL,
  total_amount NUMERIC(12,2) NOT NULL
);
الگوی پرتکرار کوئری:
-- آخرین سفارشهای یک مشتری در بازه زمانی با مرتبسازی زمانی
SELECT id, created_at, total_amount
FROM orders
WHERE customer_id = :cid
AND created_at BETWEEN :from AND :to
ORDER BY created_at DESC
LIMIT 50;
دو گزینه ایندکس داریم:
-- گزینه 1: مساوی جلو، سپس بازه، سازگار با ORDER BY
CREATE INDEX idx_orders_cust_created ON orders (customer_id, created_at DESC);

-- گزینه 2: ابتدا زمان، سپس مشتری
CREATE INDEX idx_orders_created_cust ON orders (created_at DESC, customer_id);
در گزینه 1، موتور با مساوی روی customer_id پیشوند کامل را شروع میکند، سپس بازه زمانی را محدود میکند و چون جهت مرتبسازی نیز منطبق است، معمولا نیازی به مرتبسازی اضافی نیست. در گزینه 2، فیلتر اصلی روی customer_id از پیشوند چپ استفاده نمیکند؛ موتور باید محدوده زمانی بزرگتری را اسکن کند و سپس روی customer_id فیلتر بزند و احتمالا مرتبسازی مجدد انجام دهد.
برای سنجش، از EXPLAIN/EXPLAIN ANALYZE استفاده کنید:
EXPLAIN
SELECT id, created_at, total_amount
FROM orders
WHERE customer_id = 123
  AND created_at BETWEEN '2026-01-01' AND '2026-12-31'
ORDER BY created_at DESC
LIMIT 50;
در خروجی به این موارد نگاه کنید: نوع دسترسی (Index Scan/Range Scan)، استفاده از ایندکس موردنظر، حذف یا وجود عملیات Sort، و تعداد ردیفهای تخمینی/واقعی. اگر Sort حذف شده و تعداد ردیفهای اسکنشده کم باشد، ترتیب ایندکس مناسب است.
-- کوئری 1: فیلتر برابری + بازه + مرتبسازی
WHERE status = 'PAID' AND created_at BETWEEN :f AND :t
ORDER BY created_at
-- ایندکس پیشنهادی
CREATE INDEX idx1 ON orders (status, created_at);
-- کوئری 2: فقط بازه زمانی و مرتبسازی زمانی
WHERE created_at BETWEEN :f AND :t
ORDER BY created_at
-- ایندکس پیشنهادی (سادهتر)
CREATE INDEX idx2 ON orders (created_at);
اگر عمده بار کاری شما شبیه کوئری 1 است، idx1 بهتر است. اگر اغلب بدون فیلتر status جستجو میکنید، idx2 به صرفهتر است. تلاش برای پوشش توامان هر دو با یک ترتیب، اغلب هیچکدام را عالی نمیکند.
وقتی همه ستونهای لازم کوئری از خود ایندکس تامین شوند، موتور میتواند بدون مراجعه به جدول نتیجه بگیرد (Index-Only Scan). ترتیب ستونها برای پوشش بودن ایندکس شرط نیست؛ اما برای حذف Sort و محدود کردن اسکن اهمیت دارد. اگر موتور شما امکان افزودن ستونهای شاملشونده (INCLUDE) را میدهد، آنها را پس از کلیدهای جستجو اضافه کنید تا هم پوشش حفظ شود و هم کلیدها کوچک و موثر بمانند.
اگر دو الگوی پرتکرار شما پیشوندهای متفاوتی میخواهند (مثلا یکی با customer_id شروع میشود و دیگری با status)، ساخت دو ایندکس باریکتر معقول است. همچنین اگر یک ایندکس برای حذف Sort طراحی شده اما کوئری دیگری فقط به فیلتر سریع نیاز دارد، ایندکس دوم مجرد و کوچک روی ستون فیلتر میتواند ارزان و موثر باشد.
ترتیب ستونها در ایندکس ترکیبی باید بازتاب مستقیم الگوی واقعی فیلتر، بازه و مرتبسازی شما باشد. با جلو گذاشتن مساویهای گزینشپذیر، سپس بازه و در صورت نیاز ستونهای مرتبسازی، هم اندازه اسکن را کوچک میکنید و هم هزینه Sort را حذف. فهرست کوئریهای پرتکرار را جمع کنید، دو یا سه ترتیب منطقی بسازید و با EXPLAIN روی داده واقعی بهترین را انتخاب کنید.

اگر برنامه نویس هستی و می خواهی وارد توسعه محصولات هوش مصنوعی شوی، لازم نیست از همان روز اول درباره معماری داخلی مدل...

تفاوت select_related و prefetch_related در Django به نحوه دریافت دادههای مرتبط از دیتابیس مربوط میشود. هر دو برای کاهش تعداد Query ها و...

افزایش سرعت Django Admin معمولا به بهینه سازی Query ها، مدیریت درست Model ها و کاهش عملیات سنگین داخل پنل ادمین مربوط میشود....

اگر Query های Django کند شدهاند، معمولا مشکل از استفاده اشتباه از ORM، تعداد زیاد Query ها یا طراحی نادرست ارتباط بین مدل...

Model Context Protocol AI2SQL یک استاندارد باز و نوین است که به مدلهای زبانی بزرگ اجازه میدهد به طور مستقیم و ایمن با...