هیچ محصولی در سبد خرید نیست.
5دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
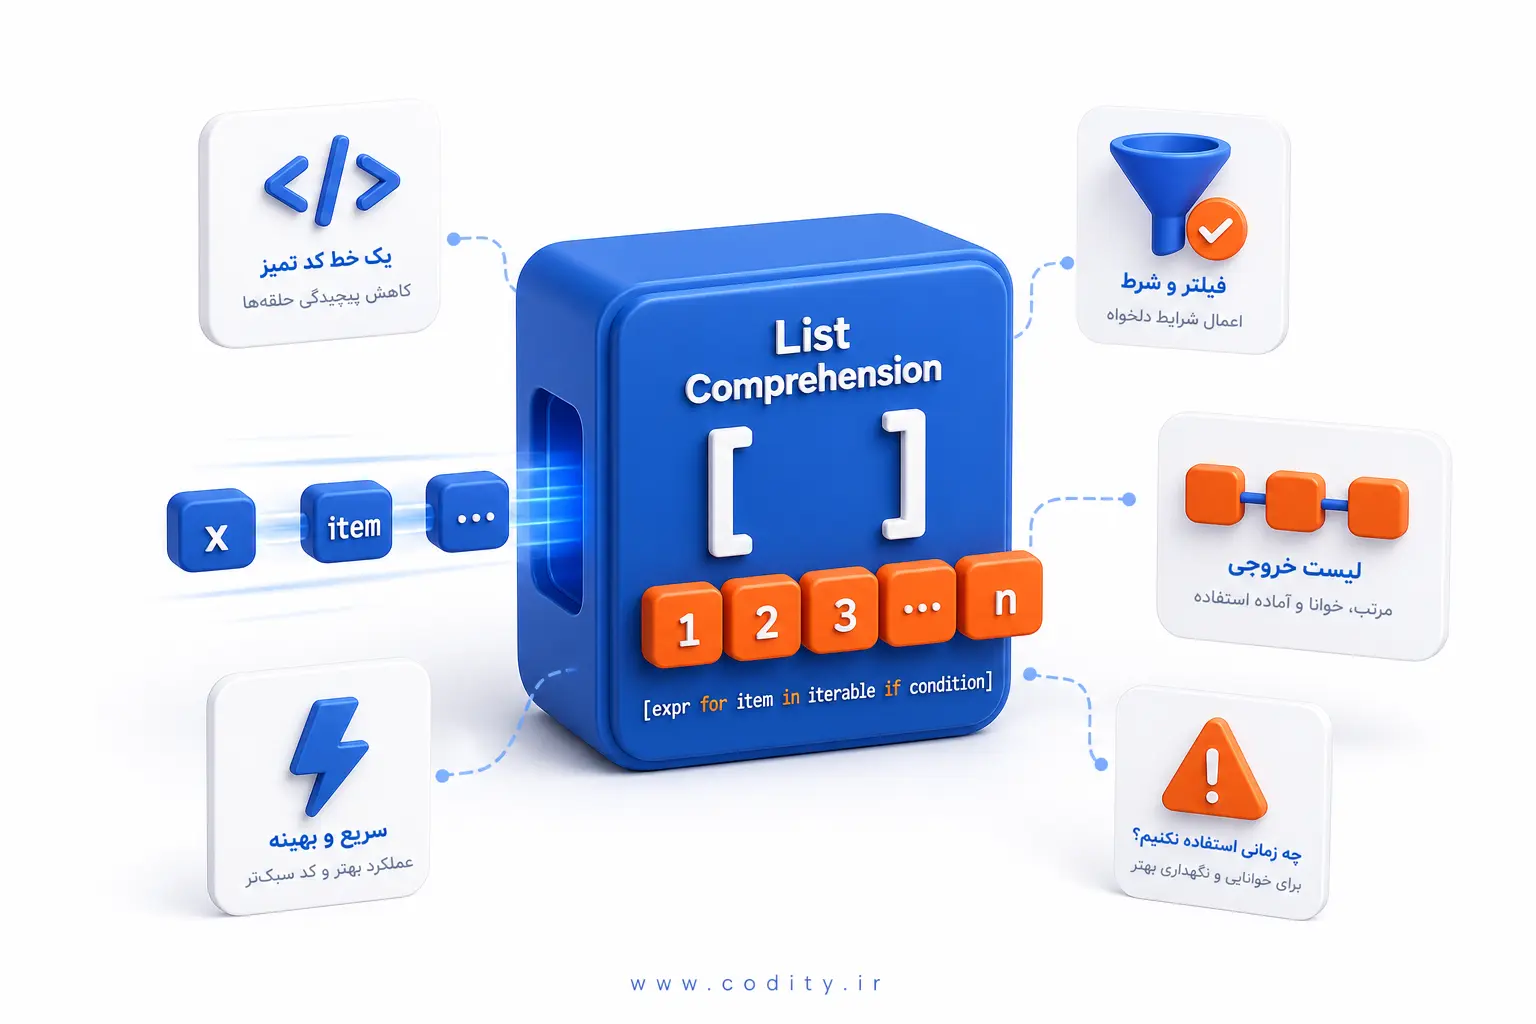
List Comprehension در پایتون روشی فشرده برای ساخت لیست جدید از روی یک توالی است؛ وقتی یک تبدیل یا فیلتر ساده می خواهید بهترین انتخاب است و زمانی که منطق چندمرحله ای، نیاز به try/except، اثر جانبی یا داده بسیار بزرگ دارید بهتر است از آن استفاده نکنید.
ساده بگوییم: یک عبارت درون براکت که روی اعضای یک توالی تکرار می کند و نتیجه هر تکرار را در لیست می گذارد. برای تبدیل عناصر (map) و فیلتر آنها در یک مرحله عالی است.
هدف: تبدیل هر عدد به مربع آن.
numbers = [1, 2, 3, 4]
squares = [n * n for n in numbers]
print(squares)  # [1, 4, 9, 16]
هدف: نگه داشتن فقط اعداد زوج و سپس مربع کردن آنها.
numbers = range(10)
even_squares = [n * n for n in numbers if n % 2 == 0]
print(even_squares)  # [0, 4, 16, 36, 64]
نکته: if در انتهای عبارت نقش «فیلتر» دارد؛ اعضایی که شرط را پاس نکنند اصلا وارد لیست نمی شوند.
اگر بخواهید هر عضو را بسته به شرطی به دو حالت متفاوت تبدیل کنید، باید if/else را در بخش تولید (پیش از for) بنویسید.
# برچسب گذاری زوج/فرد برای هر عدد
labels = ["even" if n % 2 == 0 else "odd" for n in range(5)]
print(labels)  # ['even', 'odd', 'even', 'odd', 'even']
تفاوت مهم: اینجا هیچ فیلتری وجود ندارد؛ برای هر n یک مقدار تولید می شود.
هدف: تخت کردن (flatten) یک لیست از لیست ها.
matrix = [[1, 2], [3, 4], [5, 6]]
flat = [x for row in matrix for x in row]
print(flat)  # [1, 2, 3, 4, 5, 6]
قاعده خوانایی: بیش از دو سطح تو در تو معمولا خوانایی را قربانی می کند؛ در این صورت به سراغ حلقه های معمولی یا توابعی مثل itertools.chain بروید.
می توانید از توابع کمکی داخل عبارت استفاده کنید.
# افزودن اندیس به آیتم ها
items = ["a", "b", "c"]
indexed = [f"{i}:{v}" for i, v in enumerate(items)]
# ترکیب دو لیست هم طول
xs = [1, 2, 3]
ys = [10, 20, 30]
pairs = [(x, y) for x, y in zip(xs, ys)]
جایگزین حافظه بهینه:
# generator expression: پرانتز به جای براکت
# اعضا تنبل (lazy) تولید می شوند و لیست کامل ساخته نمی شود
gen = (n * n for n in range(10**9))
# مثال مصرف: فقط 100 مقدار اول را می خواهیم
first_100 = [next(gen) for _ in range(100)]
برای اطمینان از برابری با حلقه معمولی:
def loop_squares(nums):
    out = []
    for n in nums:
        if n % 2 == 0:
            out.append(n * n)
    return out

def comp_squares(nums):
    return [n * n for n in nums if n % 2 == 0]

nums = list(range(100))
assert loop_squares(nums) == comp_squares(nums)
برای سنجش زمان اجرا بدون عددسازی قطعی، از timeit استفاده کنید:
import timeit

setup = "nums = list(range(10000))"
stmt_loop = """
out = []
for n in nums:
    if n % 2 == 0:
        out.append(n * n)
"""
stmt_comp = "[n*n for n in nums if n % 2 == 0]"

print("loop:", timeit.timeit(stmt_loop, setup=setup, number=1000))
print("comp:", timeit.timeit(stmt_comp, setup=setup, number=1000))
نتیجه بسته به نسخه پایتون و سخت افزار متفاوت است؛ معیار نهایی پروژه شما است.
# اشتباه: فکر می کند شرط فیلتر است ولی در واقع تبدیل شرطی است
vals = [("even" if n % 2 == 0 else "odd") for n in range(5)]
# درست برای فیلتر: if انتهایی
evens = [n for n in range(5) if n % 2 == 0]
# این generator است نه list
g = (n * n for n in range(5))
# اگر لیست می خواهید:
lst = [n * n for n in range(5)]
n = 10
nums = [1, 2, 3]
# n داخل comprehension نام دیگری است؛ از بازنویسی ناخواسته بپرهیزید
squares = [n * n for n in nums]
# پس از این خط، n بیرونی هنوز 10 است
# بد: تولید لیست بی مصرف فقط برای اثر جانبی print
[print(x) for x in range(3)]  # از حلقه for معمولی استفاده کنید
تبدیل فاصله های اضافی، حذف خالی ها و کوچک سازی حروف:
texts = ["  سلام  ", "", "دنیا", " PYTHON "]
clean = [t.strip().lower() for t in texts if t.strip()]
print(clean)  # ['سلام', 'دنیا', 'python']
برای استانداردسازی حروف و اعداد فارسی هم می توانید از کتابخانه های ویژه کمک بگیرید؛ راهنمای عملی را در استانداردسازی متن فارسی با Python Negar ببینید.
تبدیل لیست دیکشنری خام به اشیای تایپ شده:
from dataclasses import dataclass

@dataclass
class User:
    id: int
    name: str

raw = [{"id": 1, "name": "Ali"}, {"id": 2, "name": "Sara"}]
users = [User(u["id"], u["name"]) for u in raw]
print(users)  # [User(id=1, name='Ali'), User(id=2, name='Sara')]
اگر با dataclass آشنا نیستید، آموزش گام به گام را در آموزش dataclass در پایتون بخوانید.
rows = [[1, 2, 3], [4, 5], [], [6]]
even_flat = [x for row in rows for x in row if x % 2 == 0]
print(even_flat)  # [2, 4, 6]
اگر این الگو برایتان جا افتاد، سراغ بهینه سازی مصرف حافظه با generator ها و سپس مدل سازی داده تمیز با آموزش dataclass در پایتون بروید. برای کار با متن های فارسی نیز از استانداردسازی متن فارسی با Python Negar کمک بگیرید تا خروجی های پاک و یکنواختی بسازید.

Context Manager در پایتون روشی است برای اجرای قطعی کدهای راهاندازی و جمعبندی با دستور with؛ یعنی قبل از ورود به بلاک با...
اگر می خواهید خطاهای ناشی از نوع داده را قبل از اجرا پیدا کنید و خوانایی کد را بالا ببرید، از Type Hint...
برای جلوگیری از قرار دادن کلیدها و رمزها داخل کد، از فایل .env و کتابخانه python-dotenv در پایتون استفاده کنید: فایل .env را...
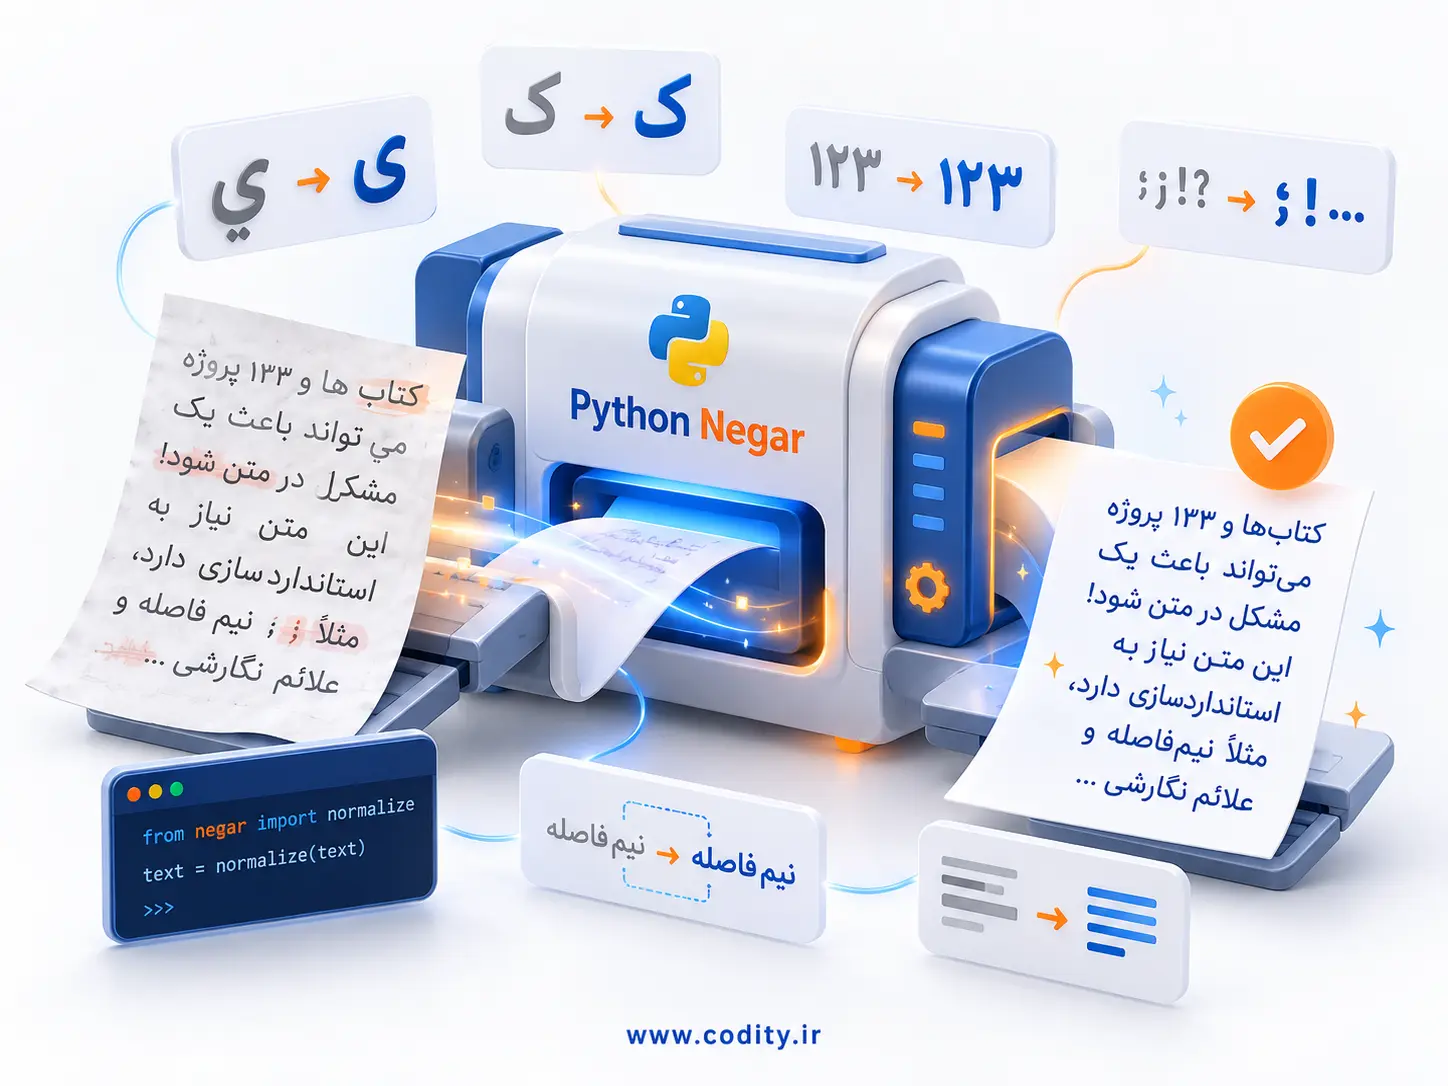
Python Negar یک کتابخانه متن باز برای ویرایش و استانداردسازی متن فارسی در پایتون است که خطاهای رایج نویسه ها، فاصله گذاری، اعداد...
برای مدیریت همزمان چند وظیفه با asyncio TaskGroup در پایتون، وظایف را داخل یک بلاک مدیریت زمینه بسازید تا همزمانی ساختارمند، کنترل خطا...