سبد خرید شما خالی است.
💻 ۱۳ سپتامبر، روز برنامه نویس مبارک؛ به همه کسانی که با کد، ایدهها را به واقعیت تبدیل میکنند. 🧡🩵
8دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
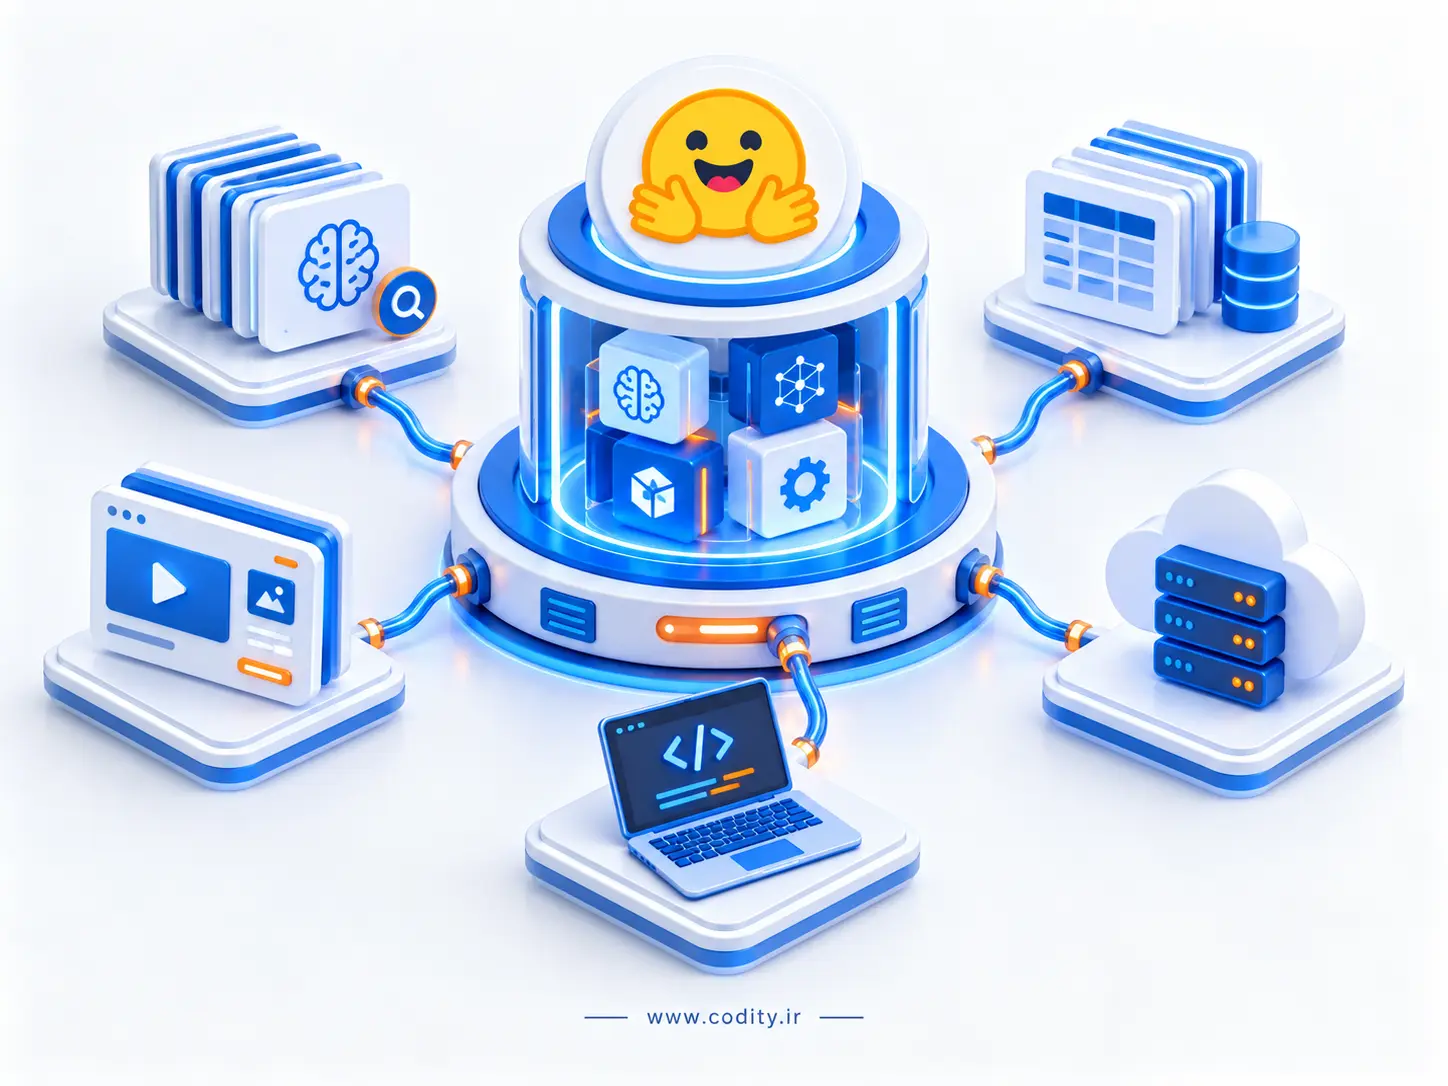
اگر برنامه نویس، پژوهشگر یا علاقه مند به هوش مصنوعی باشی، احتمالا نام Hugging Face را زیاد دیده ای. این سرویس یک پلتفرم بزرگ برای پیدا کردن، اشتراک گذاری، آزمایش و اجرای مدل های یادگیری ماشین است. توسعه دهندگان می توانند مدل آماده پیدا کنند، دیتاست دریافت کنند، دموی آنلاین بسازند یا مدل مورد نظر خود را روی زیرساخت ابری اجرا کنند. هاب این سرویس اکنون بیش از دو میلیون مدل، حدود یک و نیم میلیون دیتاست و بیش از یک و نیم میلیون برنامه هوش مصنوعی را میزبانی می کند.
هسته اصلی این سرویس Hub نام دارد. Hub را می توان تا حدی شبیه GitHub برای پروژه های هوش مصنوعی در نظر گرفت. با این تفاوت که تمرکز آن روی مدل ها، دیتاست ها و برنامه های مبتنی بر یادگیری ماشین است.
مخزن های موجود در Hub بر پایه Git ساخته شده اند و قابلیت هایی مانند نسخه بندی، تاریخچه تغییرات، Branch و همکاری تیمی دارند. افراد و سازمان ها می توانند مخزن عمومی یا خصوصی ایجاد کنند و فایل های مربوط به مدل، داده و مستندات را در یک محل نگه دارند.
این ساختار باعث می شود یک مدل فقط مجموعه ای از فایل های وزن نباشد. اطلاعاتی درباره سازنده، روش استفاده، مجوز، وظیفه مدل و گاهی نتایج ارزیابی نیز کنار آن قرار می گیرند.
Model Hub یکی از مهم ترین بخش های این اکوسیستم است. توسعه دهنده می تواند مدل ها را بر اساس نوع وظیفه، زبان، کتابخانه، مجوز یا معیارهای دیگر پیدا کند. مدل های مربوط به تولید متن، پردازش تصویر، تشخیص گفتار، Embedding و بسیاری از وظایف دیگر در این بخش قرار دارند.
هر Repository مدل می تواند Model Card داشته باشد. این صفحه معمولا درباره کاربرد مدل، محدودیت ها، زبان ها، اطلاعات آموزش و نحوه استفاده توضیح می دهد. البته کامل بودن این اطلاعات به سازنده مدل وابسته است.
در بسیاری از صفحات نیز امکان آزمایش مدل از طریق Widget وجود دارد. بنابراین قبل از دانلود مدل می توان ورودی نمونه وارد کرد و عملکرد آن را بررسی کرد.
Transformers یکی از شناخته شده ترین کتابخانه های این اکوسیستم برای استفاده از مدل های آماده است. برنامه نویس می تواند مدل سازگار را از Hub دریافت کند و آن را داخل یک برنامه Python اجرا کند.
این کتابخانه بخش زیادی از کارهای مربوط به بارگذاری مدل، Tokenizer، پردازش ورودی و اجرای Inference را ساده می کند. به همین دلیل برای آزمایش مدل های مختلف لازم نیست برای هر معماری همه مراحل از ابتدا نوشته شوند.
Transformers تنها برای مدل های زبانی نیست. بسیاری از مدل های مربوط به متن، تصویر، صدا و وظایف چندوجهی نیز از طریق این اکوسیستم قابل استفاده هستند. Hub نیز با مجموعه بزرگی از کتابخانه های یادگیری ماشین یکپارچه شده است.
آموزش و ارزیابی مدل های هوش مصنوعی به داده نیاز دارد. بخش Datasets برای پیدا کردن، انتشار و استفاده از مجموعه داده های مختلف طراحی شده است.
دیتاست های مربوط به ترجمه، تشخیص گفتار، طبقه بندی تصویر و بسیاری از وظایف دیگر در Hub وجود دارند. هر Dataset به صورت یک Repository ذخیره می شود و می تواند شامل فایل های آموزش، تست و ارزیابی باشد.
برای بسیاری از دیتاست ها Dataset Viewer نیز وجود دارد. توسعه دهنده می تواند قبل از دانلود، ساختار داده و نمونه رکوردها را در مرورگر ببیند. کتابخانه Datasets نیز امکان استفاده برنامه نویسی از این مجموعه ها و Streaming داده های بزرگ را فراهم می کند.
Spaces بخشی برای ساخت و میزبانی برنامه های تعاملی هوش مصنوعی است. توسعه دهنده می تواند مدل خود را به یک رابط وب متصل کند و نتیجه را با دیگران به اشتراک بگذارد.
Spaces به صورت داخلی از Gradio پشتیبانی می کند. همچنین می توان از Docker یا برنامه های Static HTML استفاده کرد. در صورت نیاز، امکان ارتقای منابع سخت افزاری و استفاده از GPU نیز وجود دارد.
فرض کن یک مدل تولید تصویر ساخته ای. به جای ساخت یک سایت کامل، می توانی یک Space ایجاد کنی که Prompt را از کاربر دریافت کند و خروجی مدل را نمایش دهد. این روش برای Prototype، نمایش پروژه، Portfolio و آزمایش ایده بسیار کاربردی است.
همیشه لازم نیست مدل را دانلود کنی و روی سرور خودت اجرا کنی. Inference Providers راهی برای استفاده از مدل ها از طریق سرویس های پردازش ابری است.
این قابلیت یک رابط یکپارچه برای دسترسی به صدها مدل ارائه می کند و از چند Provider زیرساختی استفاده می کند. توسعه دهنده می تواند از Python SDK، JavaScript یا درخواست HTTP برای اجرای مدل استفاده کند.
این روش برای ساخت نمونه اولیه بسیار مناسب است. مثلا می توانی یک مدل چت یا تولید تصویر را سریع آزمایش کنی، بدون اینکه ابتدا GPU تهیه و سرور مدل را پیکربندی کنی.
وقتی پروژه از مرحله آزمایش عبور می کند و قرار است در محیط Production استفاده شود، نیاز به زیرساخت قابل کنترل تری وجود دارد. Inference Endpoints برای همین سناریو طراحی شده است.
این سرویس اجازه می دهد مدل انتخاب شده روی زیرساخت اختصاصی و مدیریت شده استقرار پیدا کند. Endpoint می تواند روی منابع مختلف اجرا شود و قابلیت Autoscaling نیز برای مدیریت تغییر حجم درخواست ها وجود دارد.
در نتیجه تیم توسعه بدون راه اندازی کامل زیرساخت سروینگ مدل می تواند یک API اختصاصی برای محصول خود داشته باشد.
بله. یکی از نکات مهم این اکوسیستم این است که استفاده از مدل لزوما به سرویس ابری وابسته نیست. بسیاری از مدل ها را می توان دانلود کرد و روی سیستم شخصی، سرور شرکت یا زیرساخت اختصاصی اجرا کرد.
کتابخانه huggingface_hub حتی می تواند به سرویس های محلی مانند Ollama، llama.cpp، vLLM و LiteLLM متصل شود. در کنار آن، توسعه دهنده می تواند از Inference Providers یا Endpoint های مدیریت شده نیز استفاده کند.
انتخاب میان اجرای محلی و ابری به اندازه مدل، سخت افزار، بودجه، حجم درخواست و حساسیت داده ها بستگی دارد.
وجود یک مدل روی Hub به این معنی نیست که برای هر نوع استفاده ای آزاد است. مدل های مختلف مجوزهای متفاوت دارند و بعضی از آن ها ممکن است محدودیت هایی برای استفاده تجاری یا توزیع مجدد داشته باشند.
Model Card می تواند نقطه شروع خوبی برای بررسی این موضوع باشد. همچنین ممکن است اطلاعاتی درباره دیتاست آموزشی، محدودیت ها، Bias و نتیجه ارزیابی مدل در آن قرار گرفته باشد.
قبل از استفاده از یک مدل در محصول واقعی باید مجوز آن را بررسی کرد. همچنین بهتر است مدل با داده واقعی همان پروژه آزمایش شود، چون محبوب بودن یا تعداد دانلود بالا تضمین نمی کند مدل برای مسئله مورد نظر بهترین انتخاب باشد.
فرض کن می خواهی قابلیت خلاصه سازی متن به نرم افزار خود اضافه کنی. ابتدا می توانی مدل های مربوط به Summarization را در Hub پیدا کنی. سپس چند مدل را از نظر کیفیت، سرعت، اندازه و مجوز مقایسه کنی.
بعد از انتخاب مدل، چند مسیر داری. می توانی آن را روی سرور خودت با Transformers اجرا کنی، از Inference Provider کمک بگیری یا Endpoint اختصاصی بسازی. اگر بخواهی یک نسخه نمایشی برای تیم یا مشتری آماده کنی، Spaces نیز گزینه مناسبی است.
همین جریان کاری نشان می دهد که سرویس فقط محل دانلود مدل نیست و بخش های مختلف مسیر توسعه یک قابلیت هوش مصنوعی را پوشش می دهد.
این پلتفرم ارتباط نزدیکی با جامعه Open Source و Open Model دارد، اما همه Repository ها به یک شکل آزاد نیستند.
بعضی مدل ها Gated هستند و برای دریافت آن ها باید شرایط سازنده را قبول کرد یا درخواست دسترسی فرستاد. مخزن های خصوصی نیز برای پروژه های شخصی و سازمانی وجود دارند.
بنابراین قبل از استفاده باید شرایط همان Repository بررسی شود. عمومی بودن صفحه مدل لزوما به معنی آزاد بودن استفاده تجاری یا امکان توزیع دوباره آن نیست.
برنامه نویسان می توانند بدون آموزش مدل از صفر، قابلیت های هوش مصنوعی را سریع تر به نرم افزار اضافه کنند. پژوهشگران می توانند مدل و دیتاست منتشر کنند و کار دیگران را بازتولید کنند.
دانشجویان نیز می توانند معماری های مختلف را آزمایش کنند و با مدل های واقعی کار کنند. برای استارتاپ ها، وجود مدل های آماده و Spaces می تواند ساخت MVP را سریع تر کند.
تیم های حرفه ای نیز می توانند از Repository های خصوصی، Endpoint های اختصاصی و امکانات همکاری سازمانی استفاده کنند. در نتیجه این اکوسیستم فقط برای پروژه های آموزشی نیست و می تواند بخشی از زیرساخت محصولات واقعی باشد.
وجود تعداد بسیار زیادی مدل همیشه انتخاب را ساده نمی کند. کیفیت Repository ها یکسان نیست و بعضی مدل ها مستندات ناقصی دارند. همچنین مدل های بزرگ ممکن است به حافظه و GPU قدرتمند نیاز داشته باشند.
استفاده از سرویس های ابری نیز هزینه دارد و در پروژه هایی با داده حساس باید وضعیت حریم خصوصی و محل پردازش داده بررسی شود.
برای انتخاب مدل بهتر است فقط به محبوبیت نگاه نکنی. کیفیت روی داده واقعی، License، سرعت، اندازه، میزان حافظه و هزینه اجرا باید همزمان بررسی شوند.
این اکوسیستم مجموعه ای از ابزارها را برای مراحل مختلف توسعه هوش مصنوعی کنار هم قرار داده است. Model Hub برای پیدا کردن مدل، Datasets برای داده، Spaces برای ساخت دمو و سرویس های Inference برای اجرای مدل کاربرد دارند.
Hugging Face به همین دلیل به یکی از پلتفرم های مهم برای توسعه دهندگان هوش مصنوعی تبدیل شده است. لازم نیست همیشه مدل را از صفر بسازی. می توانی یک مدل مناسب پیدا کنی، محدودیت و مجوز آن را بررسی کنی، روی داده واقعی آزمایش انجام دهی و سپس بهترین روش اجرا را برای پروژه انتخاب کنی.
اگر برنامه نویس هستی و می خواهی وارد توسعه محصولات هوش مصنوعی شوی، لازم نیست از همان روز اول درباره معماری داخلی مدل...

اگر برای ساخت یا ویرایش تصویر از ChatGPT استفاده می کنی، ChatGPT Images 2.5 نسل جدید مدل تصویری OpenAI است که روی سه...
برای ساخت ارائه حرفه ای با Gamma AI کافی است متن خام را آماده کنید، هدف و مخاطب را در پرامپت روشن بنویسید،...
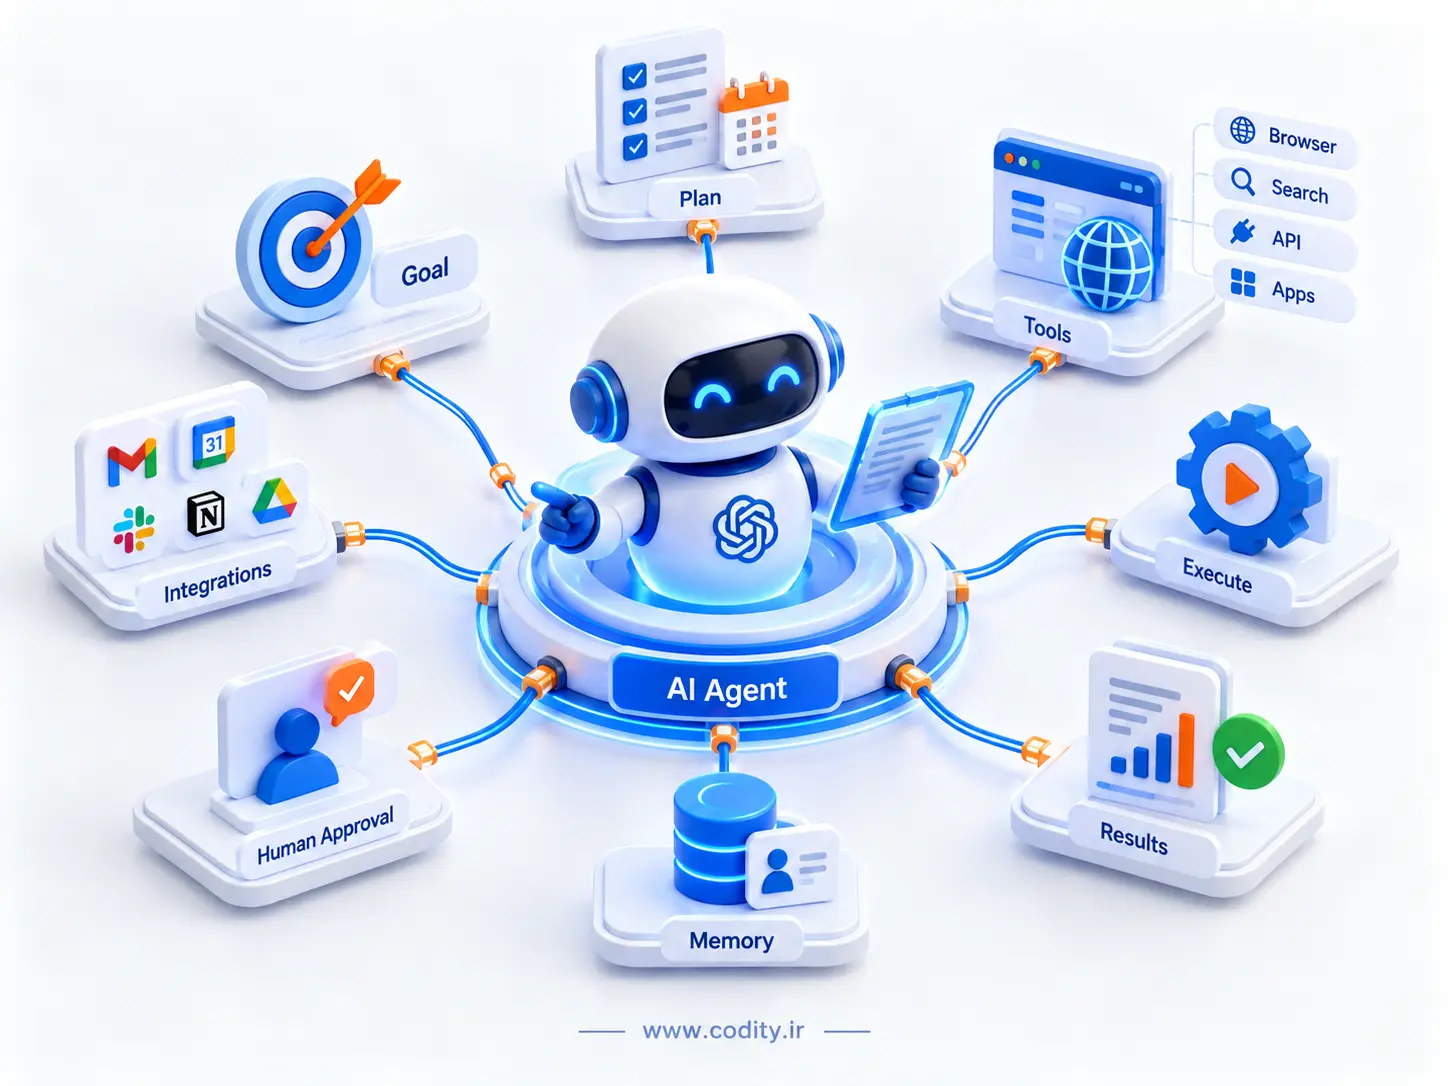
اگر بخواهیم خیلی ساده توضیح بدهیم، AI Agent یک سیستم هوش مصنوعی است که فقط به سوال پاسخ نمی دهد، بلکه می تواند...
اگر می خواهی بدانی GPT-6 Astra چیست و چرا OpenAI آن را برای سخت ترین کارهای چند مرحله ای معرفی کرده است، باید...